开放科学(资源服务)标识码(OSID):
This study proposes a hybrid modeling approach that integrates Genetic Algorithm (GA), Rough Set Theory (RST), and a Backpropagation Neural Network (BPNN). First, an initial multi-dimensional indicator system comprising 15 features was established, encompassing technical dimensions (e.g., inventor team size, CPC classification count, forward citations, scientific linkage), legal dimensions (e.g., patent validity status, first claim word count, litigation frequency, examination pendency), and economic dimensions (e.g., transaction frequency, patent family size, industry coverage breadth, technology-efficacy phrases, university-industry collaboration intensity). To mitigate feature redundancy and enhance model parsimony, GA was coupled with RST for attribute reduction, which yielded a compact subset of eight core indicators: inventor count, CPC count, forward citations, patent validity, first claim word count, examination pendency, industry coverage breadth, and technology-efficacy count.
Subsequently, a GA-BP neural network was constructed wherein GA assists in optimizing the initial weights and thresholds of the BPNN to facilitate convergence. The model was trained and validated using a balanced experimental dataset consisting of patents recognized with prestigious national awards (treated as positive samples) and a corresponding set of un-awarded patents drawn from identical technical domains. Following validation, the model was applied to a sample of invention patents from six representative universities, comprising both research and non-research universities. On the validation set, the GA-BP model demonstrated consistent improvements in classification performance relative to standard BP and PCA-BP benchmark models. While the absolute gains are modest, the pattern of enhanced predictive stability across multiple evaluation metrics suggests that the integration of GA for parameter initialization offers a viable means of improving model generalization. Furthermore, robustness checks under varying noise conditions indicated that the GA-BP framework maintained a more stable performance profile, hinting at its potential utility in handling real-world data fluctuations.
Application of the model to the six university samples allowed the identification of a substantial cohort of high-value patents. A comparative analysis revealed tentative distinctions in innovation patterns. Patents from research universities tended to exhibit characteristics associated with moderate-sized collaborative teams, relatively higher upper-bound technological impact, more efficient examination processes, and broader industry relevance. In contrast, patents from non-research universities more frequently displayed attributes such as more extensive first claim drafting and richer technology-efficacy descriptions, suggesting a greater reliance on textual elaboration and application-oriented narratives to signal value.
This study extends the patent valuation discourse by incorporating indicators such as examination pendency and technology-efficacy count, providing empirical evidence for the utility of CPC classifications in capturing application-oriented value. By juxtaposing research and non-research universities, the study illuminates heterogeneous pathways to value creation, suggesting that institutions should tailor strategies to their specific ecosystems. Specifically, while research universities might prioritize interdisciplinary collaboration and procedural optimization, other institutions may find greater value in meticulous claim drafting and articulating practical benefits. Ultimately, this model offers a decision-support mechanism to assist technology transfer professionals and policymakers in triaging patent portfolios, aiming to facilitate the efficient translation of academic research into societal and economic benefits.
开放科学(资源服务)标识码(OSID):
2020年11月,习近平总书记在中共中央政治局第二十五次集体学习时强调, “创新是引领发展的第一动力,保护知识产权就是保护创新”。党的二十大报告提出,“加强知识产权法治保障”,“集聚力量进行原创性引领性科技攻关”。作为国家创新体系的核心引擎,研究型大学在当前技术迭代周期加速态势下,应具备精准锁定并剖析技术变革契机的能力,将技术机遇转化为技术优势,进而在基础研究前沿发挥引领作用。然而,研究型大学积累的庞大专利库虽为技术机遇提供了土壤,却也因筛选机制的复杂性,成为专利转化的一道障碍。国家知识产权局发布的《2022年中国专利调查报告》显示,2022年我国高校发明专利实施率为16.9%,其中产业化率仅为3.9%,与发达国家存在较大差距。中国日报网数据显示,2022年美国高校专利转化率高达50%,约是中国高校转化率的13倍。这揭示出我国研究型大学虽然专利数量持续增长,但转化率普遍较低。2023年10月,国务院办公厅印发《专利转化运用专项行动方案(2023—2025年)》,提出“梳理盘活高校和科研机构存量专利”,“识别存量专利产业化潜力”,“促进财政资助科研项目的高价值专利产出和实施”。如何从海量专利中精准、高效识别出具有高转化潜力的“高价值专利”,成为破解高校科技成果转化难题、释放研究型大学创新潜能的关键所在。因此,有必要对研究型大学高价值专利测度体系进行研究,以为其优化专利全流程管理、实施精准化转化策略,以及政府部门制定靶向性激励与资源配置政策提供参考。
高价值专利测度研究主要以构建评价指标体系为主。前期研究多以单一维度指标为主,如专利被引特征等[1],研究视角较窄。近年来,学者普遍从多维特征视角进行综合评判。周小琴等[2]从发明人水平、引用专利数量等技术维度分析专利创新性;Wei等[3]从权利要求数量、专利寿命等法律维度衡量专利保护强度和稳定性。然而,现有指标体系存在主观赋权、指标共线性与冗余度高等问题,且缺少对研究型大学专利转化特征的考量。评估方法上,传统无形资产评估方法(如成本法、市场法、收益法)存在忽视未来收益[4]、市场分析不成熟[5]等不足。随着大数据技术的发展,机器学习方法得到广泛应用,包括梯度提升树、人工神经网络算法。这些方法虽提升了评估的客观性,但仍面临如下挑战:一方面,模型输入指标未经优化和筛选,导致维度指标过拟合问题;另一方面,多数黑箱模型的可解释性较弱,且其参数优化多依赖经验试错,会影响模型性能与稳健性。为此,本文采用遗传算法(GA)与BP神经网络相结合的方法,通过GA实现特征指标的智能约简与网络参数的全局优化,构建结构精简、性能稳健的高价值专利识别模型,并解析关键影响因素,为优化专利布局提供决策参考。
本文主要探究以下问题:如何构建有效的高价值专利评价指标体系?如何高效识别研究型大学的高价值专利?如何推动研究型大学塑造高价值专利?基于此,本研究致力于构建一个有效的研究型大学高价值专利识别模型。不同于以往研究,本研究一方面在初选指标体系中增设“审查时长”“技术功效”等指标,以求多方面对研究型大学高价值专利进行有效识别。另一方面,探索一种遗传算法(GA)与BP神经网络相结合的建模路径。在该路径中,遗传算法主要用于协助完成两项任务:一是与粗糙集理论结合以对初选的高维指标特征进行约简,筛选出关键特征子集,以降低模型输入的冗余度;二是对BP神经网络的初始权值与阈值进行全局搜索优化,以改善模型的收敛起点与稳定性。BP神经网络则承担最终的识别任务,依托其非线性映射能力,构建从专利特征到价值分类的预测模型。通过两者结合,在特征筛选与模型训练环节实现协同优化,从而增强高价值专利识别过程的准确性与稳健性。
20世纪70年代初,美国卡内基教育促进基金会对研究型大学进行定义,并以博士授予数量和科研经费规模等作为研究型大学的主要划分依据。我国结合高等教育发展实际,逐步形成对研究型大学的本土化认知,认为研究型大学是以知识传播、生产与应用为中心职能,以高水平科学研究与高层次精英人才培养为核心目标,在国家创新体系中居于引领地位的大学。当前,我国“双一流”高校建设正是以“建设一批高水平研究型大学”为目标,重点支持一批高校率先建成世界一流大学和一流学科[6]。在此背景下,国内学术界普遍将“双一流”建设高校视为研究型大学的核心代表。如周光礼等[7]以148所“双一流”建设高校作为研究型大学的代表样本,指出中国研究型大学概念与世界一流大学概念大致重合;许赞等[8]则将39所“985工程”高校视为我国研究型大学的典型范例。2017年教育部公布的42所世界一流大学建设高校既是“双一流”战略重点建设的核心高校,同时也涵盖39所“985工程”高校,在科研实力、人才培养层次及社会贡献等方面均显著领先于其他高校,是我国研究型大学的典型代表。因此,本文将42所世界一流大学建设高校界定为研究型大学,为方便比较分析,将其他大学作为非研究型大学。
高价值专利是一个综合性概念,通常指法律稳定性强、技术创新水平高、市场前景广阔,能够在法律、技术与经济多个维度为企业创造价值的专利或专利组合[9]。广义上讲,其包括高市场价值和高战略价值专利;狭义上讲,仅指具有高经济价值的专利[3]。结合产业发展背景,高价值专利主要是指在战略性新兴产业或特色优势产业中,由企业主导、整合多方创新资源,通过产学研合作转化的高标准、高市场潜力专利或专利组合[10]。现有研究多从经济、法律、技术3个维度定义高价值专利[9-10]。本文认为,高价值专利既包括能带来经济收益或市场优势的专利,也包括文本品质优良、技术原创性强、能推动科技进步、市场潜力大且易于在国际范围内有效维权的专利。
在识别高价值专利前,需要厘清能够彰显专利价值差异的关键要素范畴,构建合乎逻辑、科学严谨的专利价值评价指标体系。当前,多数学者将专利价值影响要素划分为3类,即技术要素、法律要素、经济要素。如Grimaldi等[11]从技术要素和经济要素中筛选出5个代表性指标,集成为专利组合价值指数,用来评价专利创新水平;Zhou等[12]通过深入研究专利生命周期,从技术发明、申请审核、授权保护到市场转化4个关键环节,凝练出与技术、法律及经济3个影响要素紧密相关的15个评价指标,据此构建专利价值评价指标体系;张黎等[13]参考模糊集理论,将关联专利价值的要素划分为技术水平、经济价值、权利保护3个维度。基于上述研究,本文从技术价值、法律价值、经济价值3个维度构建高价值专利评价指标体系。
(1)技术价值维度。高价值专利的技术价值体现为其在技术层面的先进性、复杂性与影响力,这一维度可通过多个互补指标进行测度。①发明人规模与专利技术复杂性存在一定相关性[14]。在大学开展协作创新的环境中,价值较高专利往往意味着复杂的研究过程和多元知识融合,通常涉及的发明人数量也较多(程秀才等,2025)。②专利IPC分类号数量表征专利技术领域覆盖广度[15],故本文用IPC分类号数量表征专利技术应用范围。李睿和范九江[16]指出高校专利IPC数量反映专利技术功能丰富程度,即专利技术价值。③联合专利分类号(CPC)是基于IPC发展而来的国际专利分类体系,相较于IPC分类号,其版本更新较快、分类细化程度更高,且更侧重于应用分类[17],即分类标准与技术实际应用场景和具体产品关联更紧密、更易于解读,因此能够更有效地揭示专利技术应用领域与市场潜力[18],从而为专利价值分析提供更贴合产业实践的分类依据。④技术深度反映专利技术与知识流动以及专利技术来源与发展趋势[19],其与专利价值也存在一定相关性[20]。⑤专利技术影响力用专利被引次数衡量,专利被引次数越高,表明越具有基础性与开创性[21],因此越能反映专利价值[22]。⑥科学关联度用专利引用非专利文献的数量表征。该指标用来衡量专利技术创新潜力[4],反映专利是否建立在深厚的学术研究和前沿技术探索之上[23]。Gambardella等[24]的研究表明,引用非专利文献较多的专利,其往往具有较高的科学关联性与创新质量,从而对专利整体价值产生积极影响。
(2)法律价值维度。法律价值维度是评估专利稳定性、保护强度与法律地位的基础。在此维度,本文选取专利有效性、首权字数、诉讼次数和审查时长4个指标。①专利有效性是指专利当前的合法程度,一般分为无效、审中、有效3个环节,处于有效状态的高校专利意味着高校发明人持续支付费用维持专利有效性,始终保留其未来进入技术市场的“入场券”[25]。因此,现有研究通常将专利有效性作为高价值专利评价的基础条件,认为专利有效意味着其具有市场价值,无效则意味着其无市场价值[26]。②首权字数对专利价值也存在影响,在技术方案相对成熟、保护范围对市场价值影响较大的领域,专利字数越少、保护范围越宽,专利的潜在价值越突出;而当技术复杂或审查环境严格时,适当增加字数反而是确保专利授权质量、稳定专利权利基础的务实选择[18]。③专利诉讼次数反映专利的重要性,对于同一涉案专利,若权利人提起多次侵权诉讼, 表明该专利价值较高(李晓桃等,2019)。④审查时长与专利技术的复杂性、新颖性以及审查过程中的沟通修改密切相关,较长审查时长意味着专利经历了严格的实质性审查,其授权结果往往具有较高的稳定性和技术含量,更能反映专利技术价值。
(3)经济价值维度。市场交易、商业运营是专利价值创造的重要阶段,对于促进高校科技成果转化十分重要。本研究综合考虑专利的市场转化潜力、国际布局广度、技术通用性及产学研协同效应,选取交易次数、同族国家数、产业覆盖宽度、技术功效与校企合作5个关键指标。①专利交易体现专利在技术市场的流动性与价值实现能力,通常包括转让、许可、质押等形式(魏太琛等,2020)。Zhang等[27]指出,专利交易是评价专利价值的关键指标,专利交易频次越高,说明该专利在市场中更具认可度,其经济价值也就越高。②同族国家数反映专利在全球范围的布局广度,广泛的国际布局能降低专利在单一国家被侵权的风险,增强其市场竞争力(冉从敬等,2023)。此外,维持多国专利的高成本也体现了申请人对专利商业价值的认可。③产业覆盖宽度是评估专利技术通用性与跨界融合潜力的重要指标(窦路遥等,2025)。专利覆盖的国民经济行业越广,其潜在经济价值和技术影响力也就越大。④技术功效是专利主题挖掘与价值评估的核心概念[28],主要是指专利文本描述的技术问题与技术效果。技术功效数量是评价专利解决复杂技术问题的重要指标,也是专利价值横向维度的主要表现。⑤校企合作专利往往更贴近产业需求,具备较强的转化导向与市场适应性,同时对合作企业也具有较大的经济价值(冉从敬等,2023)。参考孙笑明等[4]的研究,用大学专利申请人中企业数量与总申请人数量之比计算,旨在捕捉大学专利产业合作情况。
综上,专利价值评价指标体系如表1所示。
表1 专利价值评价指标体系(初选)
Table 1 Patent value evaluation index system (preliminary)
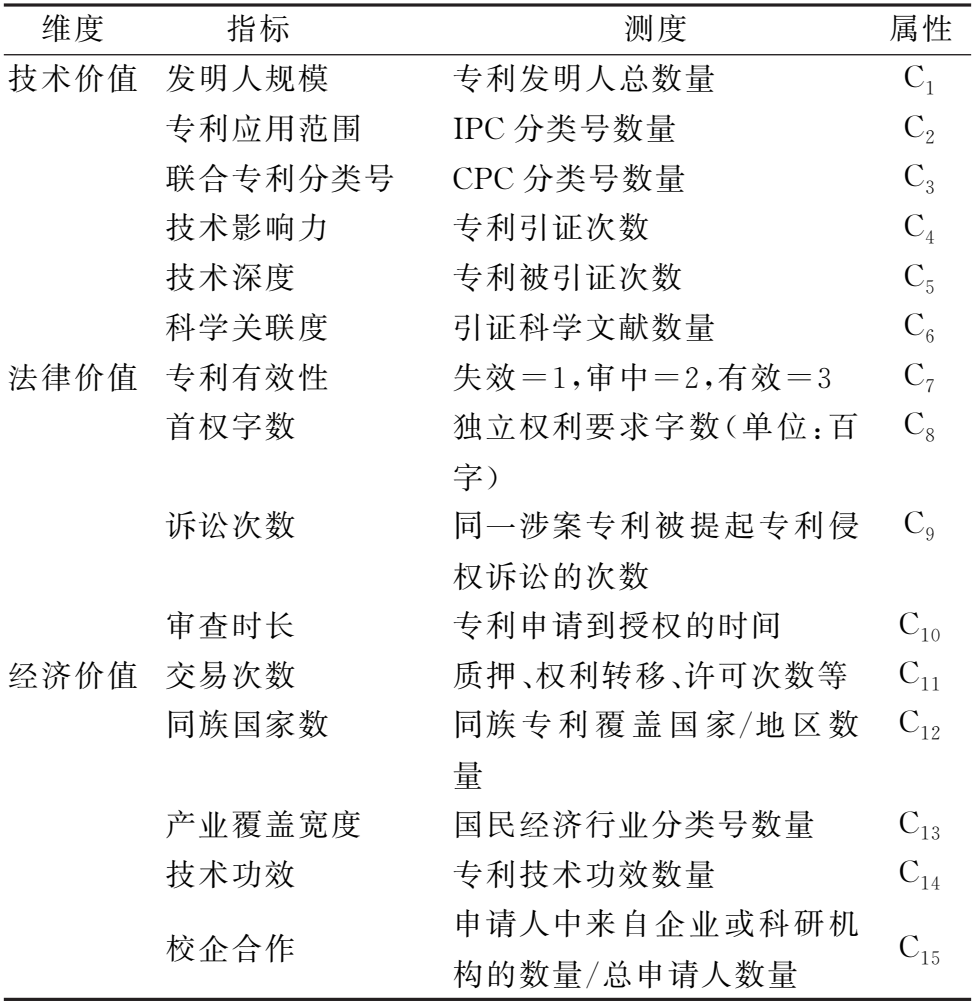
维度 指标 测度 属性 技术价值 发明人规模 专利发明人总数量 C1 专利应用范围 IPC分类号数量 C2 联合专利分类号 CPC分类号数量 C3 技术影响力 专利引证次数 C4 技术深度 专利被引证次数 C5 科学关联度 引证科学文献数量 C6 法律价值 专利有效性 失效=1,审中=2,有效=3 C7 首权字数 独立权利要求字数(单位:百 字) C8 诉讼次数 同一涉案专利被提起专利侵 权诉讼的次数 C9 审查时长 专利申请到授权的时间 C10 经济价值 交易次数 质押、权利转移、许可次数等 C11 同族国家数 同族 专 利 覆 盖 国 家/地 区 数 量 C12 产业覆盖宽度 国民经济行业分类号数量 C13 技术功效 专利技术功效数量 C14 校企合作 申请人中来自企业或科研机 构的数量/总申请人数量 C15
本文构建高价值专利识别逻辑框架(见图1),步骤如下:①从智慧芽(PatSnap)全球专利检索数据库中提取实验数据,在模型训练时将其划分为高价值专利组和非高价值专利组。②通过Matlab软件编码,运用遗传算法对高价值专利特征指标进行约简;在此基础上,构建基于GA-BP神经网络的高价值专利识别模型,利用实验数据寻找模型的最优特征指标与参数,最终完成预测模型的构建。③从智慧芽专利数据库中获取研究型大学样本专利数据,通过预测模型识别高价值专利,进而分析促进国内研究型大学科技成果有效转化的措施。
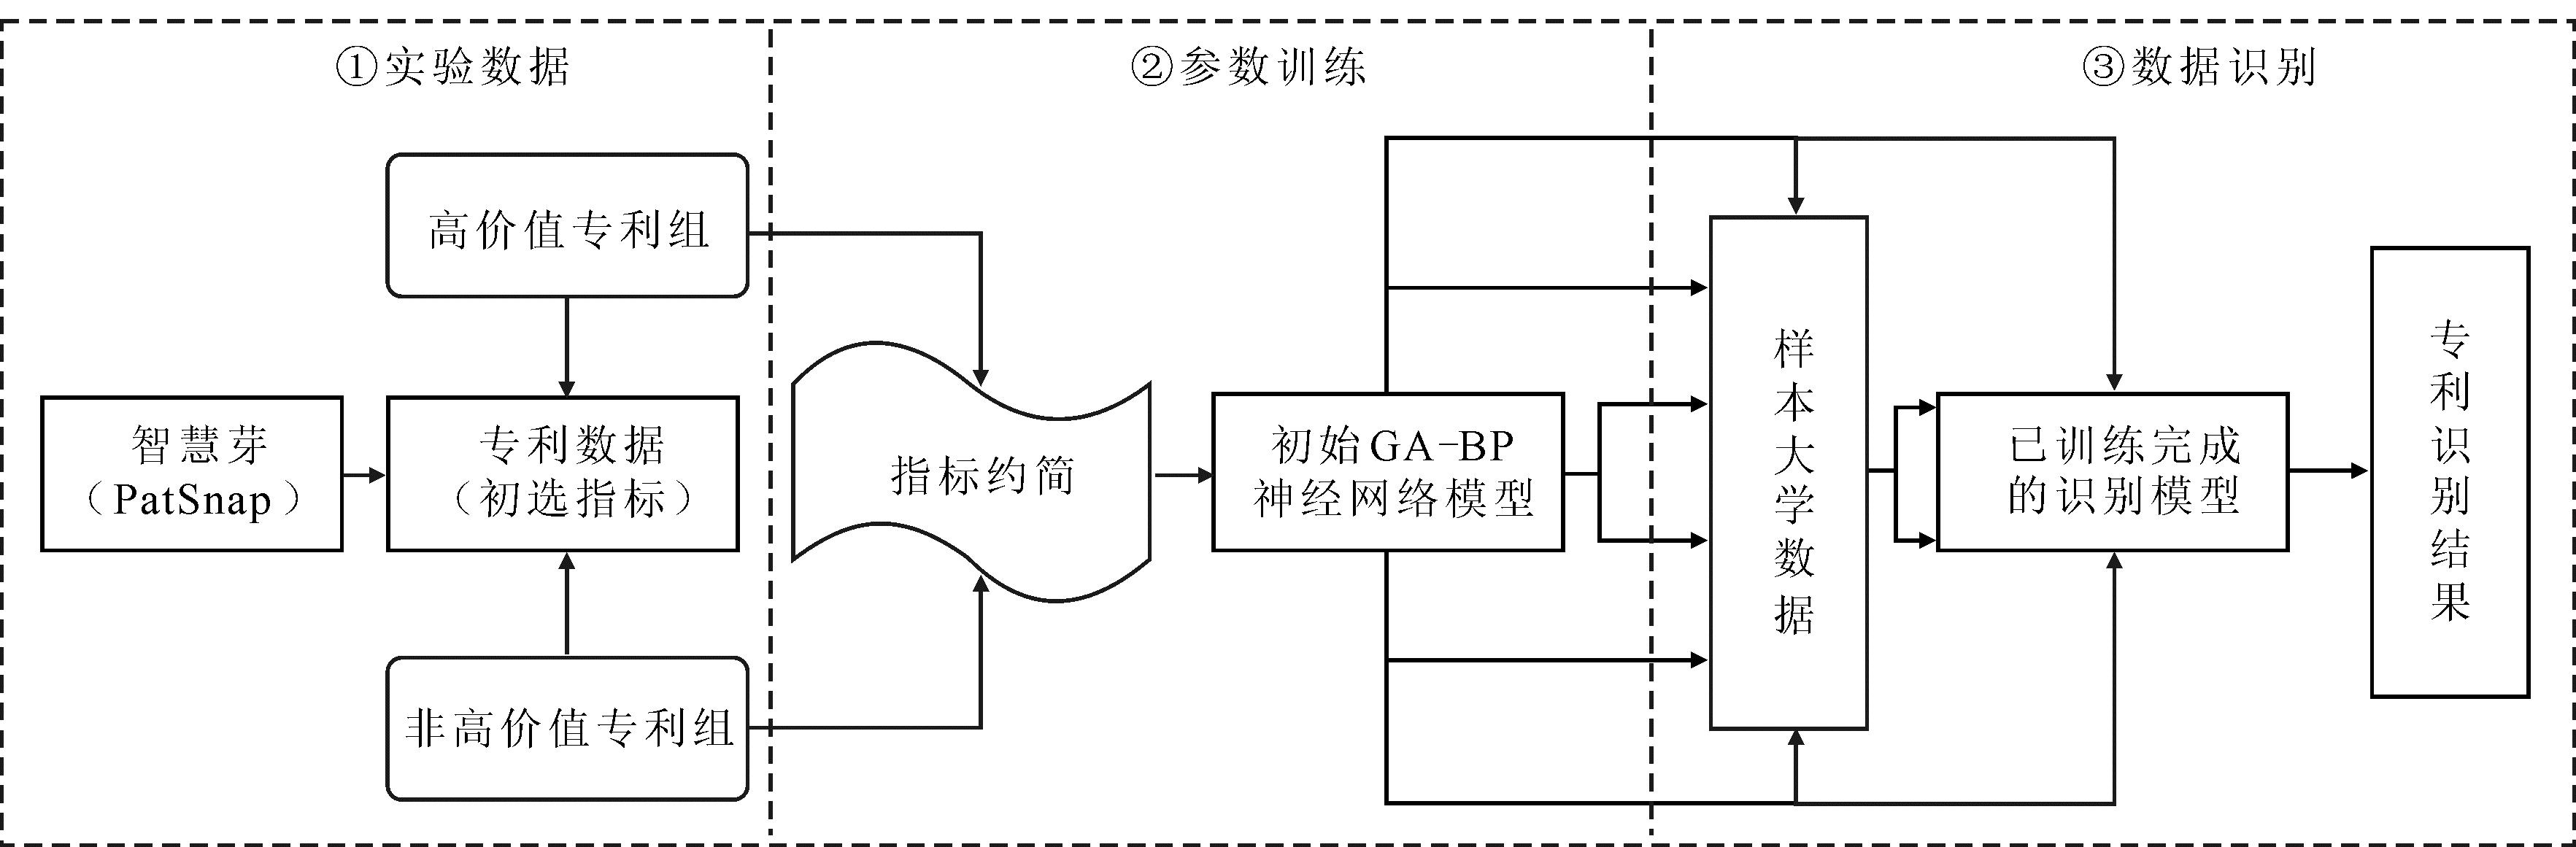
图1 高价值专利识别逻辑框架
Fig.1 Logic frame of high value patent recognition
(1)数据来源。2021年10月,国务院印发的《“十四五”国家知识产权保护和运用规划》明确,获得国家科学技术奖、中国专利奖的发明专利计入高价值发明专利统计范畴。同时,参考孙笑明等[4]的研究,不同行业领域在专利特征等方面虽存在差异,但不会对高校专利价值评估产生较大影响。因此,本研究选取获得国内第二十四届、第二十五届中国专利奖的发明专利标记为高价值专利,即正样本,共3 108条。同时,为确保正负样本在技术领域的可比性,避免因领域不匹配而引入混淆偏差,本文首先基于IPC主分类号(大类)分析上述获奖专利的技术领域分布,如表2所示。从中可见,获奖专利主要集中在G部(电学)、H部(物理)、C部(化学)等理工类学科,包括计算、电气元件、通信、材料等技术领域,且每个技术领域占比差距较小。据此,本文在上述获奖专利所集中的G部、H部、C部等IPC大类领域内,另行随机抽取3 108条未曾获得过任何奖项的专利,将其作为非高价值专利(负样本),以确保正负样本技术领域分布的可比性。
表2 研究样本技术领域分布情况
Table 2 Distribution of experimental data in technical fields
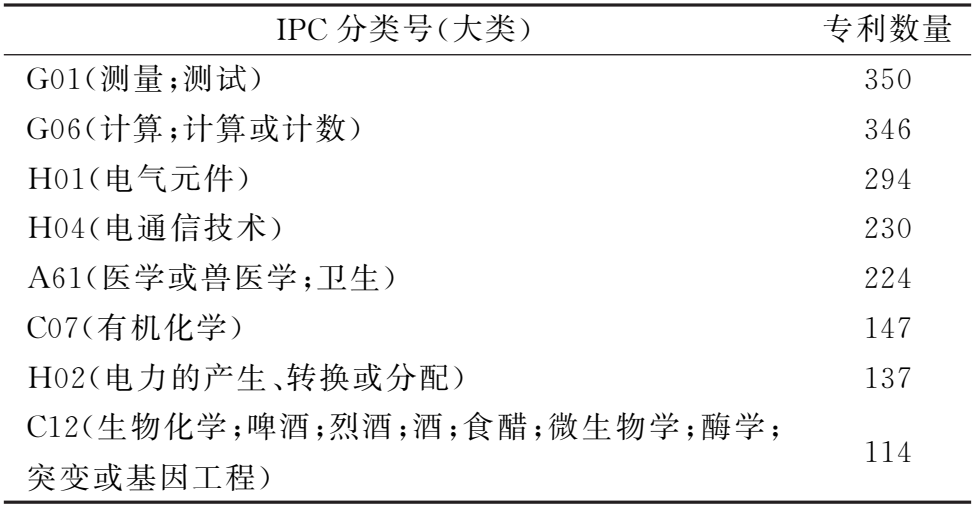
IPC分类号(大类) 专利数量 G01(测量;测试) 350 G06(计算;计算或计数) 346 H01(电气元件) 294 H04(电通信技术) 230 A61(医学或兽医学;卫生) 224 C07(有机化学) 147 H02(电力的产生、转换或分配) 137 C12(生物化学;啤酒;烈酒;酒;食醋;微生物学;酶学; 突变或基因工程) 114
(2)高校样本选取。据全球知识产权综合信息服务提供商IPRdaily与大为全球专利数据库联合统计,在2023年中国高校有效发明专利排名中,清华大学、浙江大学与东南大学3所研究型大学的有效发明专利数量最多,而在非研究型大学中,浙江工业大学、江苏大学、广东工业大学的有效发明专利数量最多,见图2。为兼具数量优势与类型代表性,同时能系统比较研究型与非研究型大学高价值专利差异,本文选取上述6所大学2019—2024年的197 441件有效发明专利作为数据样本。
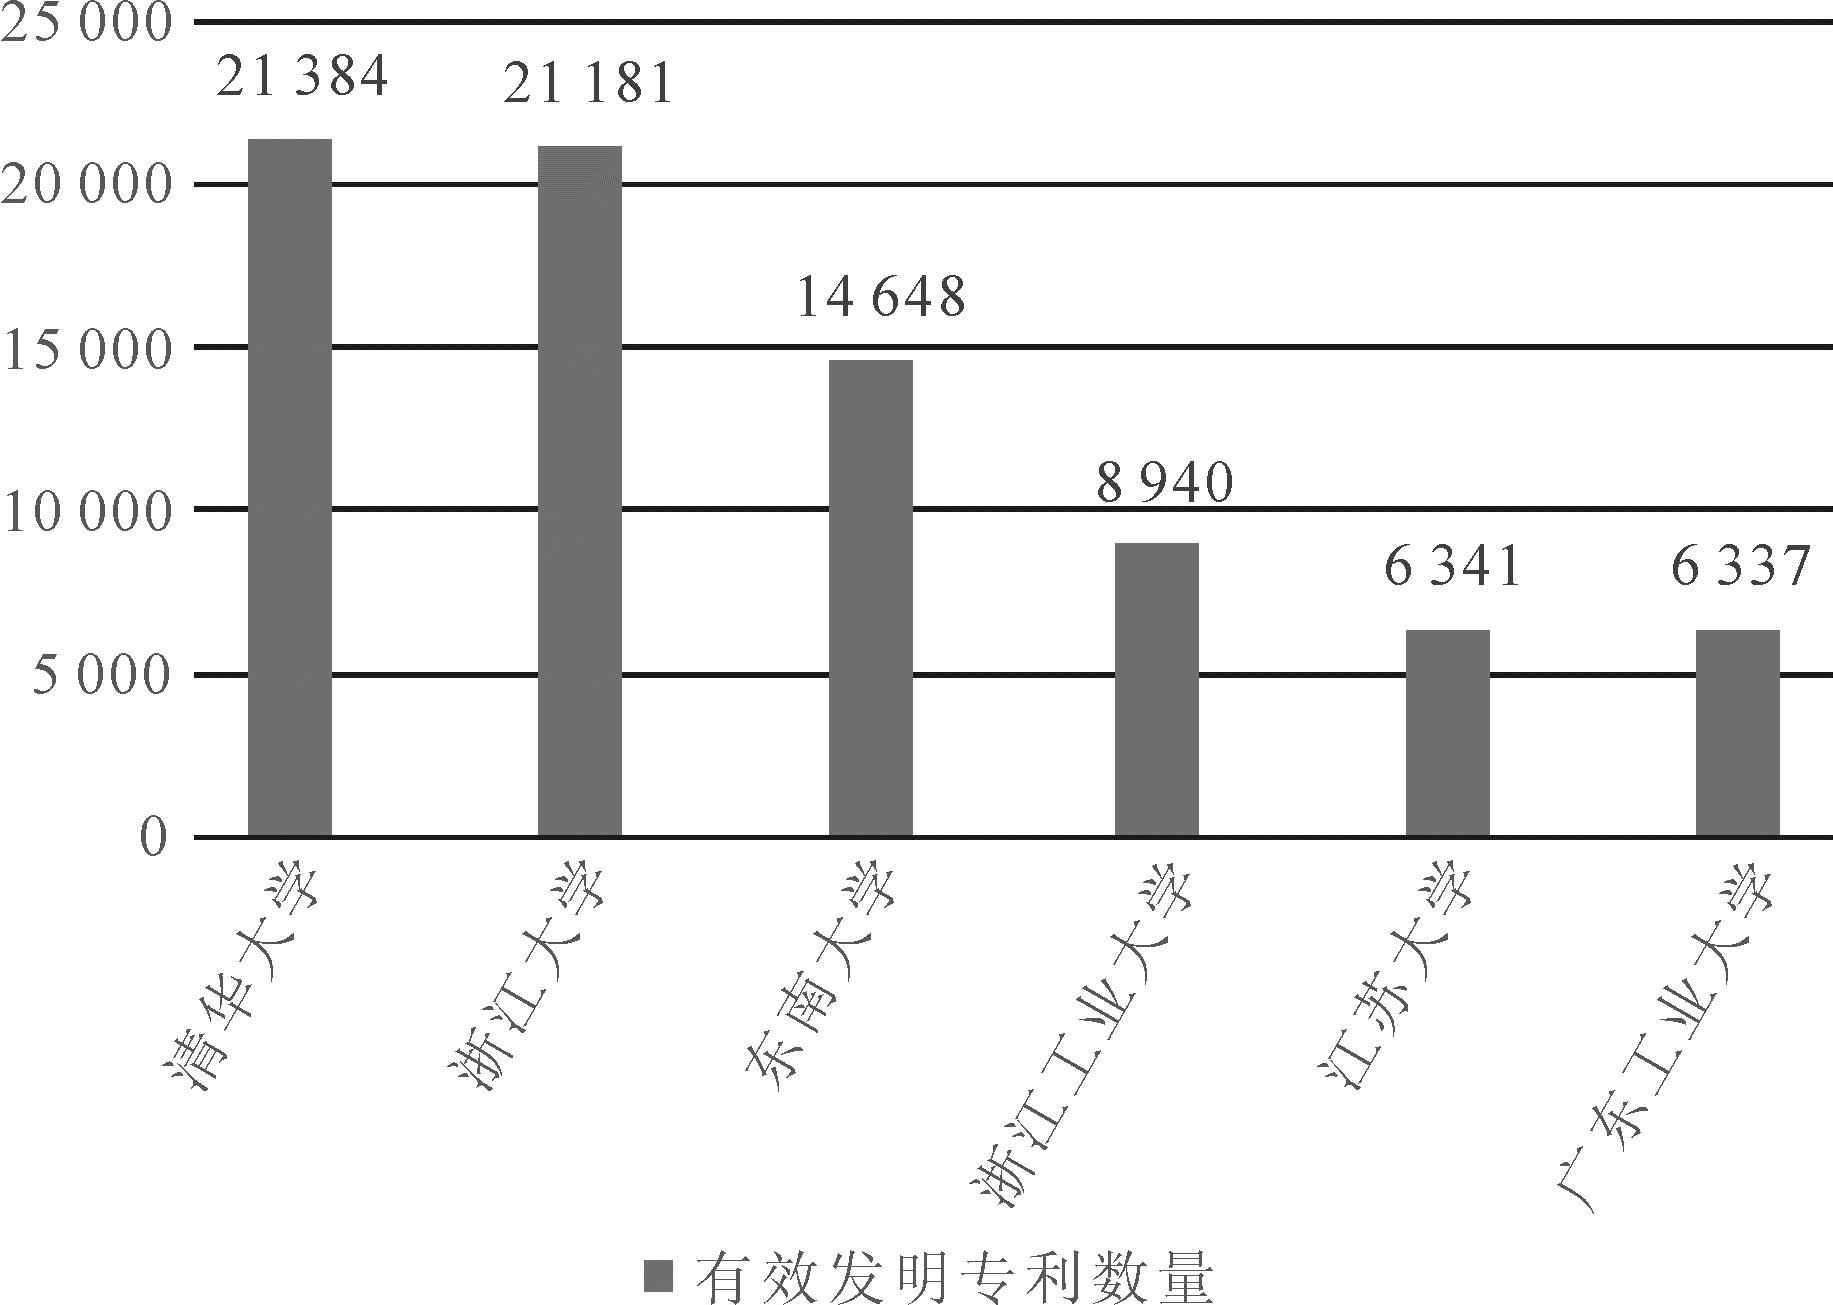
图2 研究样本大学有效发明专利数量
Fig.2 Numbers of valid invention patents of sample universities
为减少评价指标体系中可能含有的冗余信息或指标相关性较强的情况,本文采用遗传算法与粗糙集理论相结合的方法对专利价值指标评价体系进行特征约简。遗传算法是一种模拟自然选择和遗传学机制的全局优化搜索算法,其通过种群迭代进化来寻求最优解,尤其适用于解决特征选择组合优化的问题,能够有效评估特征之间的交互作用并找到性能优良的特征子集[29]。粗糙集理论是一种处理不精确、不一致和不完备信息的数学工具,能够在无需先验知识的前提下,通过知识约简发现数据中隐含的决策规则。其核心思想是:利用等价关系对论域进行划分,从中找出可明确分类的正域,再以这些样本的比例(依赖度)衡量属性子集的分类能力(柯洪等,2012)。
首先,将15个原始指标通过等频离散化转换为3个离散区间(分别对应低、中、高3个等级),以满足粗糙集对离散数据的要求。在此基础上,构建高价值专利识别决策表,以15个指标为条件属性,以专利是否为高价值专利为决策属性,形成包含全部训练样本的决策表矩阵。其次,运用遗传算法对指标特征进行约简,参考沙首伟等(2019)的研究,将参数设为初始种群60、交叉概率0.7、变异概率0.01、迭代50代,约简规则设为如果绝大多数研究对象均不包含某一特征,则此特征在当次约简过程中应被剔除。基于上述特征约简规则,对识别指标进行约简,经9次筛选后得到最小特征集为C1、C3、C4、C7、C8、C10、C13、C14(各特征被选频率如图3所示),分别代表发明人规模、联合专利分类号、技术影响力、专利有效性、首权字数、审查时长、产业覆盖宽度、技术功效,以上8个指标可较好地测度专利价值,最后一次约简对应的迭代过程如图4所示。由图4可知,在最小约简条件属性下,当迭代10步时适应度基本趋于平稳,整体能够较好地满足分析需求。
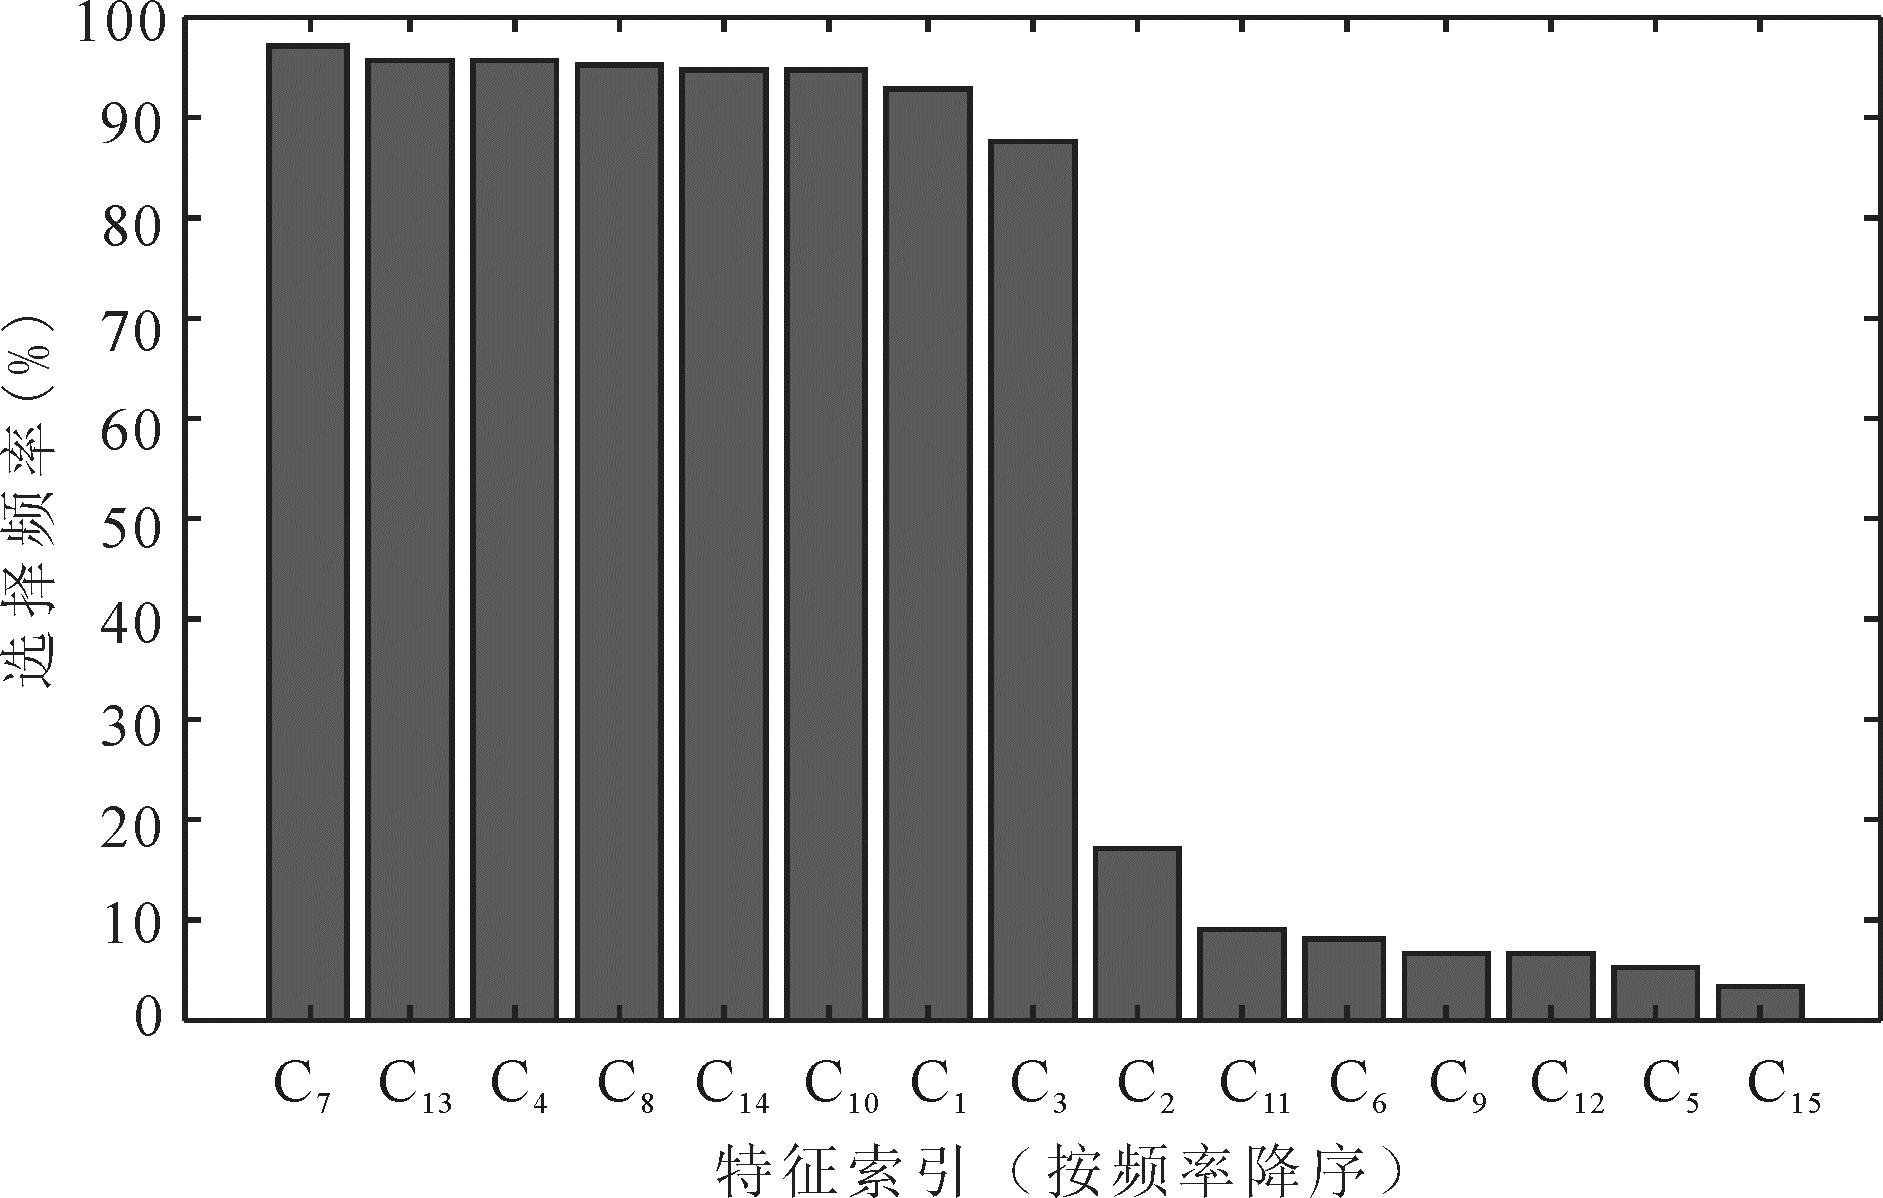
图3 特征选择频率分布
Fig.3 Frequency distribution of feature selection
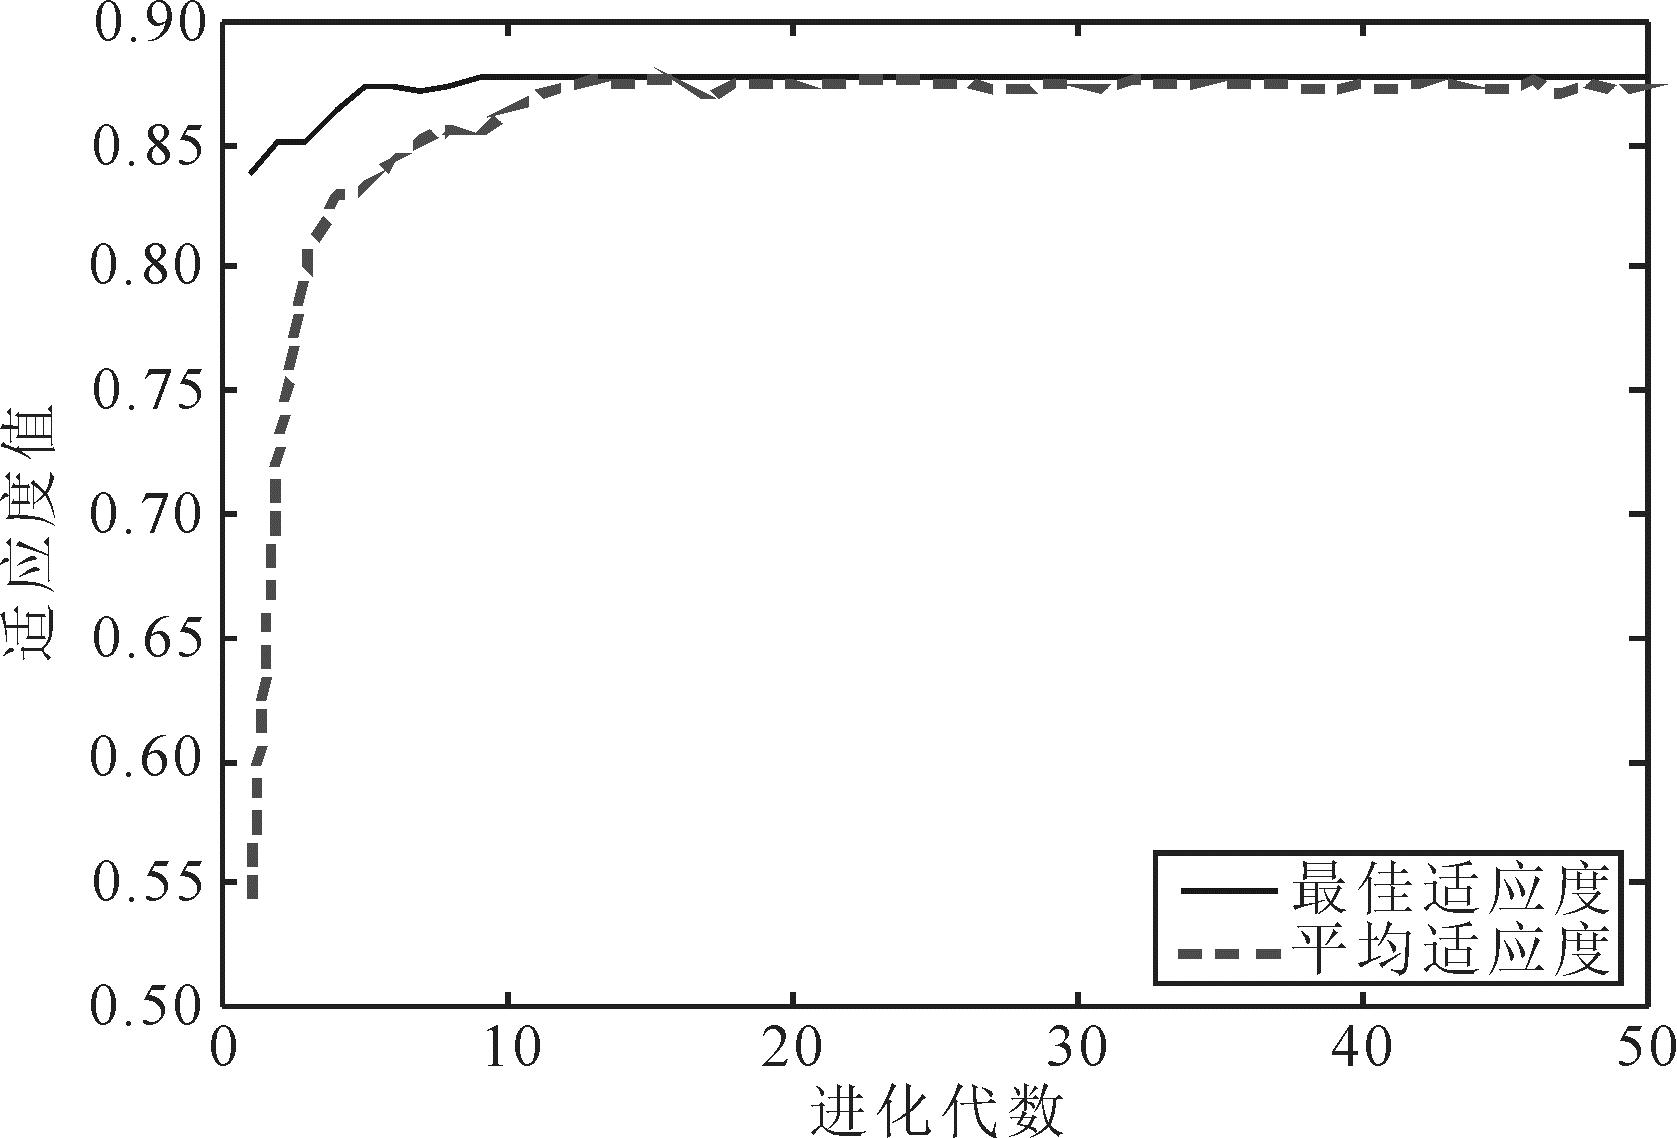
图4 遗传算法适应度进化曲线
Fig.4 Evolution curves of genetic algorithm fitness
BP神经网络是一种通过误差反向传播进行训练的多层前馈网络。其性能高度依赖初始权值和阈值,若初始化不当,则容易导致训练收敛慢或陷入局部极小值,从而影响模型可靠性。针对高价值专利测度这一复杂分类问题,本文用GA在解空间(即所有权值与阈值的可能组合集合)内进行并行搜索,寻找BP神经网络更优的初始权值与阈值组合,以克服随机初始化的不足,使网络训练从一个更佳的起点开始,从而增强最终评价模型的泛化能力和稳定性。
本研究依据遗传算法筛选出的特征指标,对实验数据与高校样本数据进行系统化处理。首先,对于3 108条正样本和3 108条负样本,分别提取筛选后的特征值,将正样本标记为1、负样本标记为0,构建带标签的训练数据集。对6所大学2019—2024年的197 441条专利样本,提取对应的特征值进行预测识别。在数据清洗阶段,对缺失值和异常值采用同一技术领域同类专利的均值进行填补,以确保数据一致性与可靠性。考虑到各特征指标量纲差异,采用最小—最大归一化方法将全部特征线性映射至0~1区间,以加速模型收敛。最后,将预处理后的实验数据按8∶2的比例随机划分为训练集和验证集,训练集用于模型参数的学习与优化,验证集用于评估模型的泛化识别能力。
(1)BP神经网络模型。本研究首先构建标准BP神经网络作为基准模型,旨在验证高价值专利的非线性可分性,并为后续模型优化提供基础。BP神经网络采用经典的单隐含层结构(见图5),其核心是通过误差反向传播算法调整网络权值与阈值,以最小化预测输出标签与真实标签之间的误差。针对高价值专利识别的二分类特性,将输入层节点数设为8,对应约简的指标数量。将输出层节点数设为1,采用purelin激活函数,将网络输出映射至实数域,进而得到二分类判别结果。隐含层节点数是影响模型性能的关键指标,采用“sqrt(m+n)+a”经验公式的搜索策略,其中m为输入节点数,n为输出节点数,a为调节参数。通过设置a从1到10进行迭代实验,分别测试不同隐含层节点数下模型在验证集上的均方误差与分类准确率,最终选定均方误差最低且准确率最高对应的隐含层节点数作为最佳结构,从而在模型容量与泛化风险之间取得平衡。网络训练采用带动量的梯度下降法,设置学习率为0.01,最大迭代次数为1 000,目标误差为1×10⁻⁵。该基准模型的主要作用在于确认所选特征能够被神经网络有效学习,进而区分高价值专利,其性能表现(如准确率、召回率等)将作为后续GA-BP模型优化效果的对照基准。
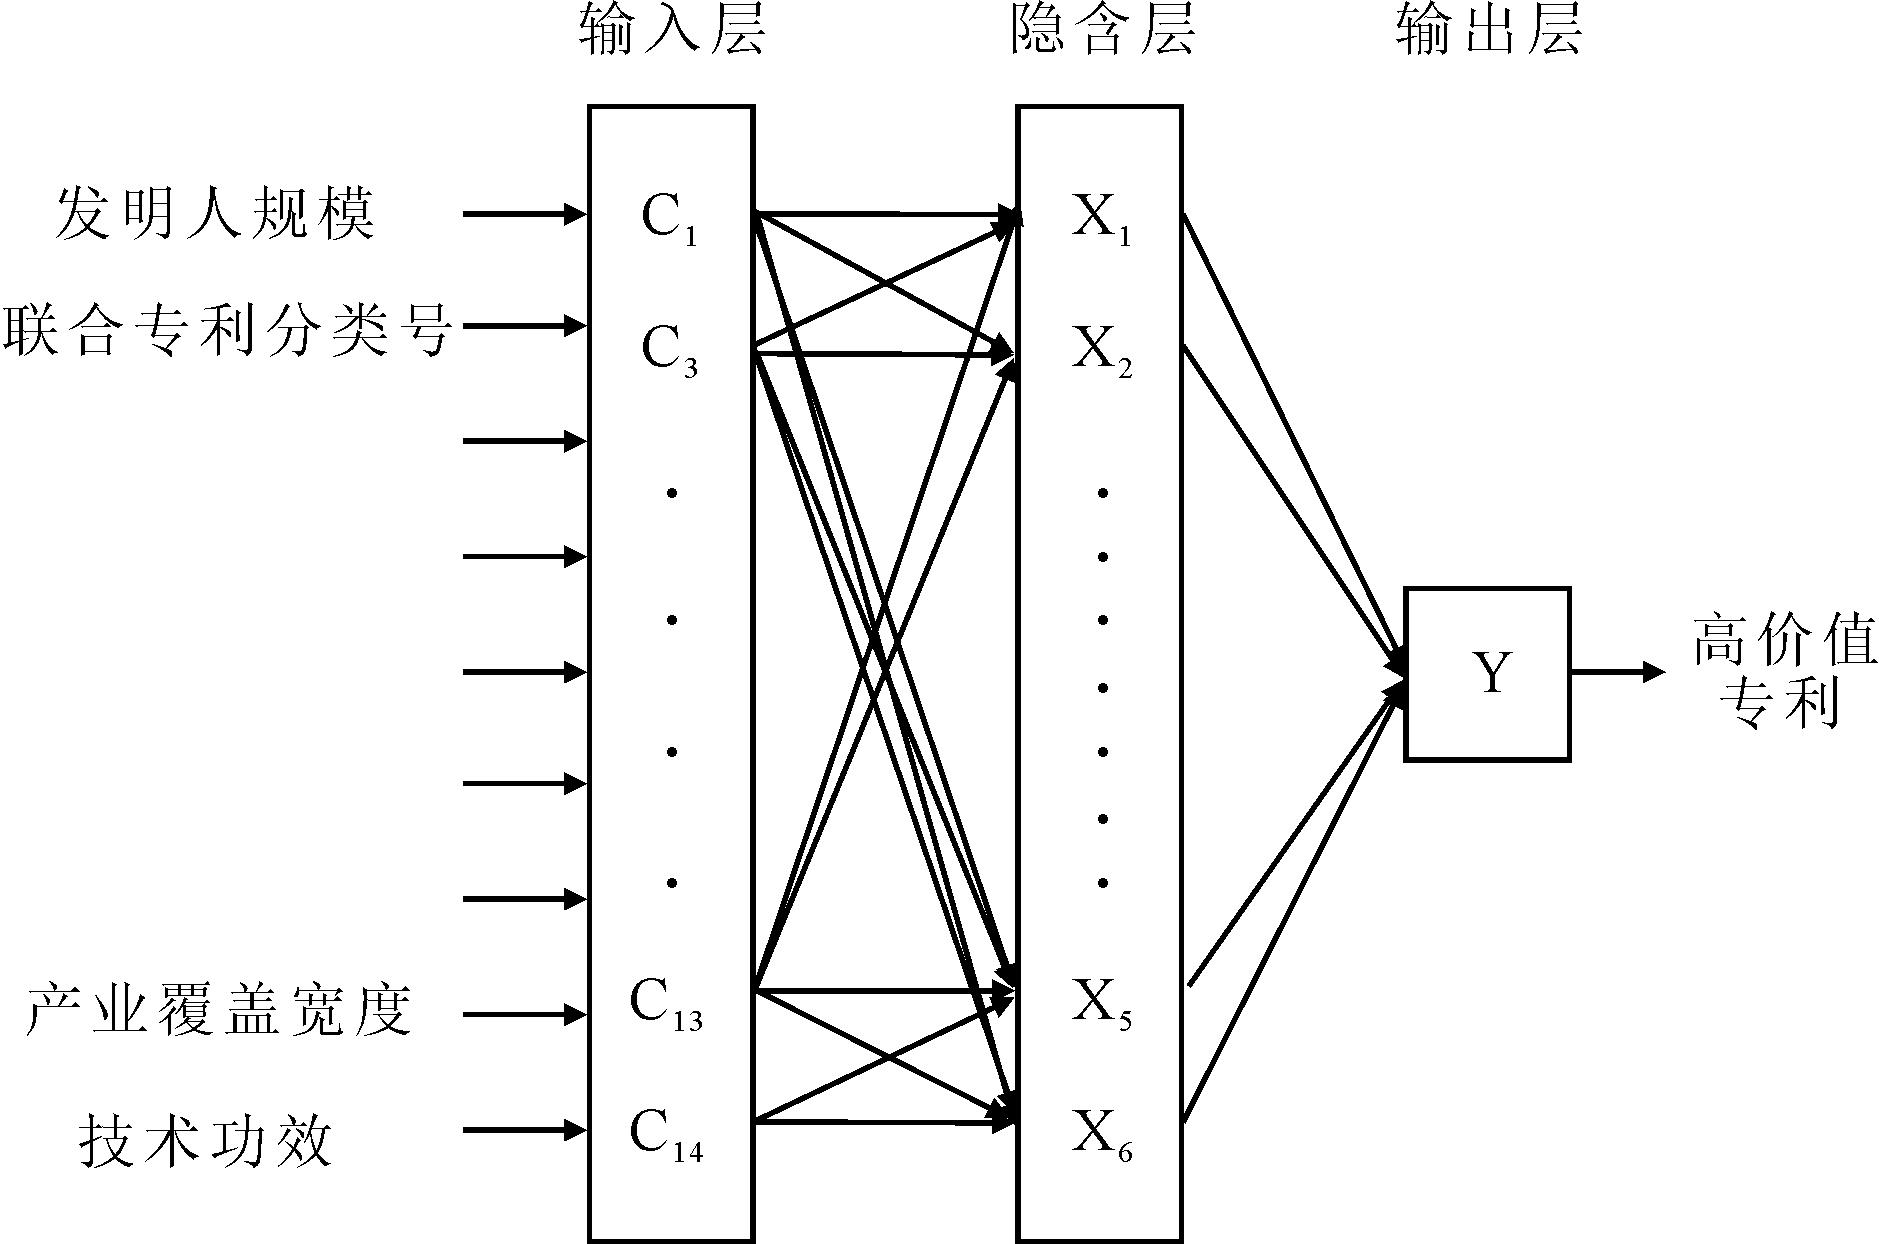
图5 单隐含层BP神经网络
Fig.5 Single-hidden-layer BP neural network
以上述隐含层节点计算公式提供的起点开始迭代,对不同节点下的均方误差(MSE)和准确率进行比较。各节点值见表3,选取准确率最高(0.977 6)的节点,即最佳隐含层神经元节点数量为6。
表3 不同隐含层神经元节点数下的准确率
Table 3 Accuracy under different numbers of neurons in hidden layers
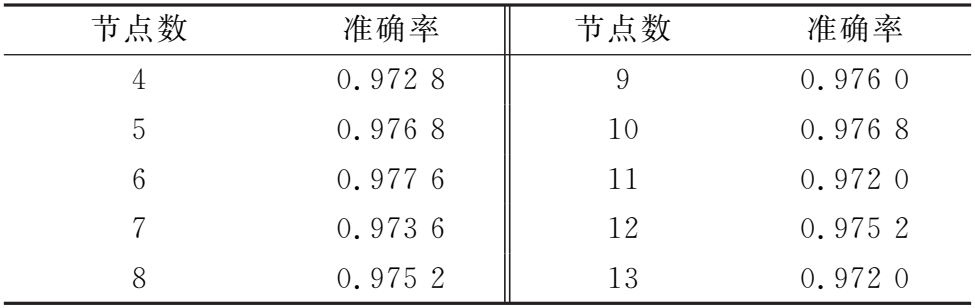
节 点 数 准 确 率 节 点 数 准 确 率 4 0 . 9 7 2 8 9 0 . 9 7 6 0 5 0 . 9 7 6 8 1 0 0 . 9 7 6 8 6 0 . 9 7 7 6 1 1 0 . 9 7 2 0 7 0 . 9 7 3 6 1 2 0 . 9 7 5 2 8 0 . 9 7 5 2 1 3 0 . 9 7 2 0
(2)GA-BP神经网络模型。为对研究型大学高价值专利进行精准、稳健识别,本研究在标准BP神经网络的基础上引入遗传算法,构建GA-BP神经网络模型。该模型紧密围绕高价值专利识别核心目标与研究数据特征展开,旨在克服传统BP神经网络在应用此类复杂、非线性分类问题时对初始参数敏感、易陷入局部最优的不足,从而提升模型的识别精度与泛化能力。具体构建流程如下:第一步,参数编码与问题映射。针对前期约简得到的专利评价指标,本文将BP神经网络中连接这8个输入节点(约简后的指标数量)、6个隐含层节点及1个输出节点(对应高价值专利综合测度值)的所有权值与阈值,按照顺序编码为一个实数向量(染色体);将神经网络参数优化问题转化为一个面向高价值专利分类性能的全局搜索问题。第二步,种群初始化与搜索空间定义。随机生成规模为50的初始种群,每个个体代表一套可能的网络初始参数。种群规模设定权衡搜索广度与计算效率,确保能在解空间内充分探索适用于专利数据特征的良好初始点。第三步,适应度函数设计。适应度函数是引导遗传算法进化的核心,直接关联研究目标。本文将适应度定义为个体所对应神经网络在训练集上的均方误差(MSE),MSE越小反映模型对高价值专利的预测偏差越低,从而确保进化过程始终以提升回归与分类判别能力为导向,使算法筛选出的参数组合能够准确区分高价值专利与非高价值专利。第四步,遗传操作与进化优化。通过选择、交叉和变异操作模拟自然进化,迭代更新种群。将最大进化代数设为100,并设有早停机制(最佳适应度连续20代未提升),在追求性能提升的同时避免不必要的计算。经过进化,算法输出全局最优染色体,即为BP神经网络经过全局搜索优化的初始权值与阈值,GA-BP神经网络流程如图6所示。
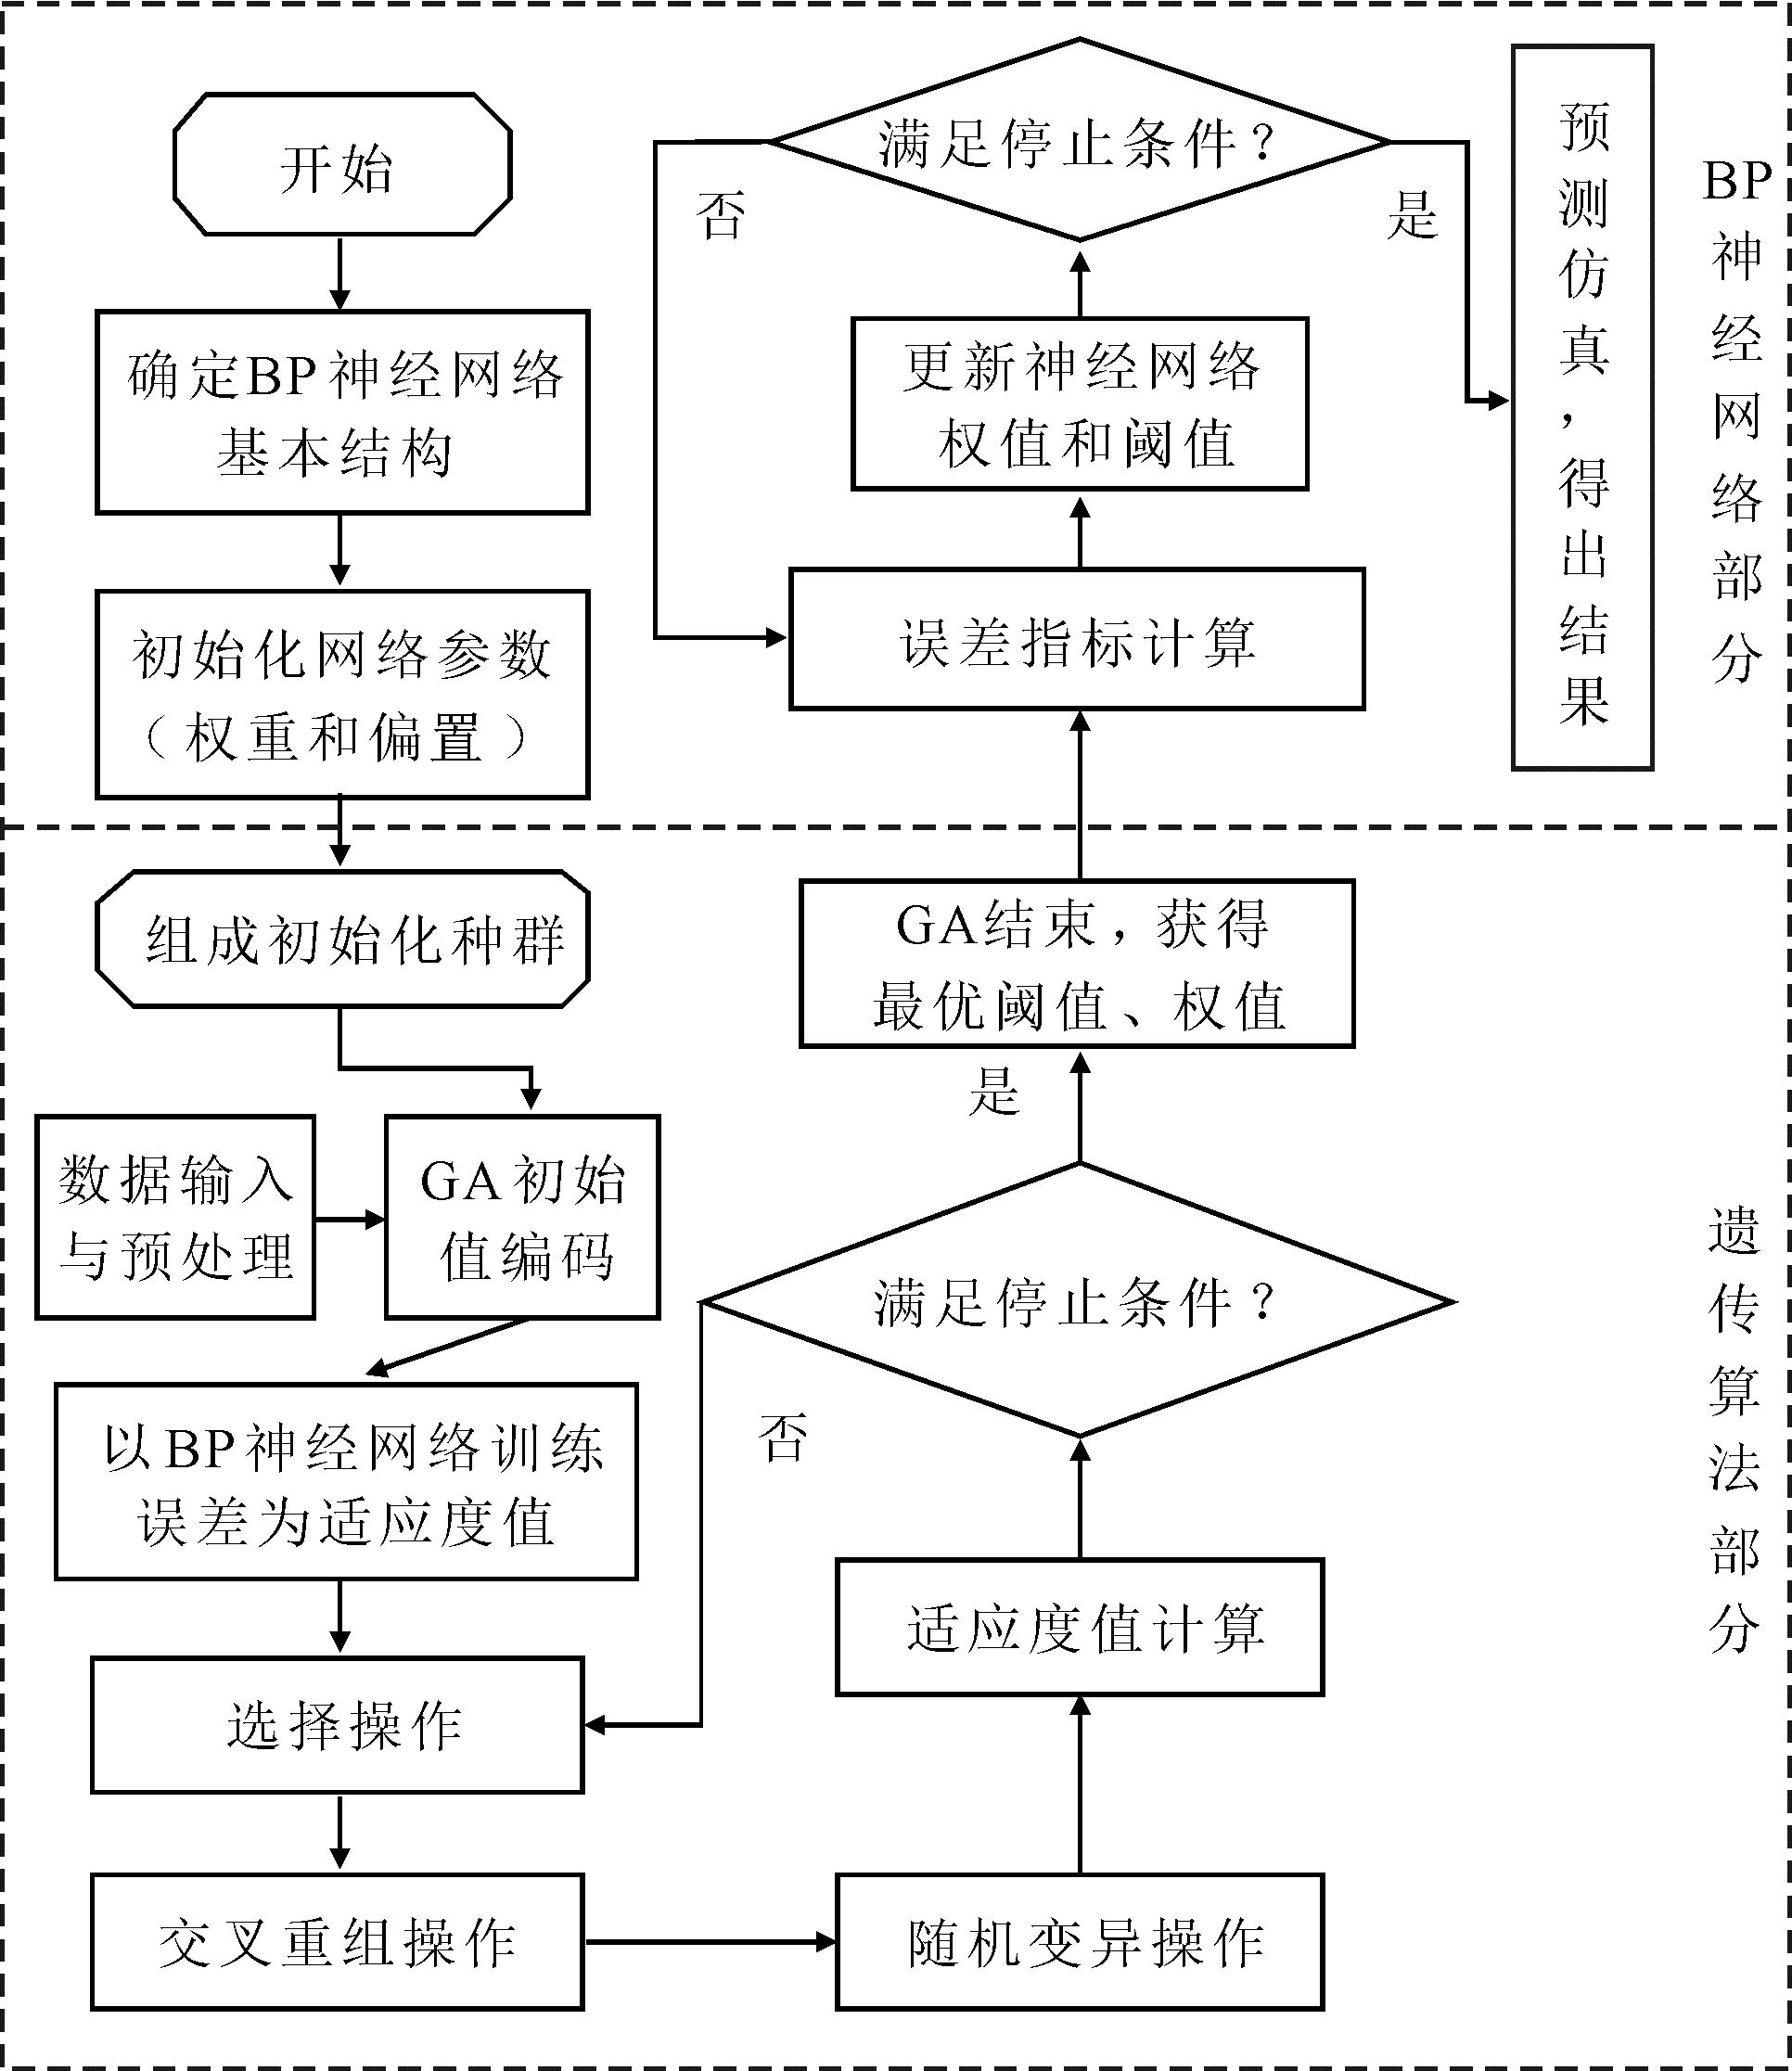
图6 GA-BP神经网络流程
Fig.6 GA-BP neural network flow
为更全面地评估遗传算法对BP神经网络性能的优化效果,将所构建的GA-BP神经网络与标准BP神经网络、PCA-BP神经网络综合性能进行对比,如表4所示。从误差指标看,GA-BP模型在平均绝对误差、均方误差、均方根误差和平均绝对百分比误差上均取得最优值,且均低于标准BP神经网络模型与PCA-BP神经网络模型。这表明,经过遗传算法优化后,模型整体预测偏差与离散程度降低,预测值与真实值更为接近。在分类性能方面,GA-BP模型展现出一定优势,其准确率、精确率、召回率和F1值均为三者最高。这表明,遗传算法的引入有效优化了神经网络的初始参数,使GA-BP模型获得最佳的泛化能力与分类稳健性。尽管各项指标提升的绝对幅度看似有限,但这种全面、一致的领先优势在统计上具有重要意义,表明“GA全局寻优+BP局部微调”策略的有效性。GA-BP在保留原始特征信息的基础上进行优化,其性能优于通过特征降维的PCA-BP神经网络模型,这也间接验证了前期约简指标的必要性与有效性。总体而言,GA-BP神经网络作为高价值专利识别工具具有一定优越性,为后续分析与应用提供了基础。
表4 三种模型误差对比
Table 4 Comparison of errors of the three models
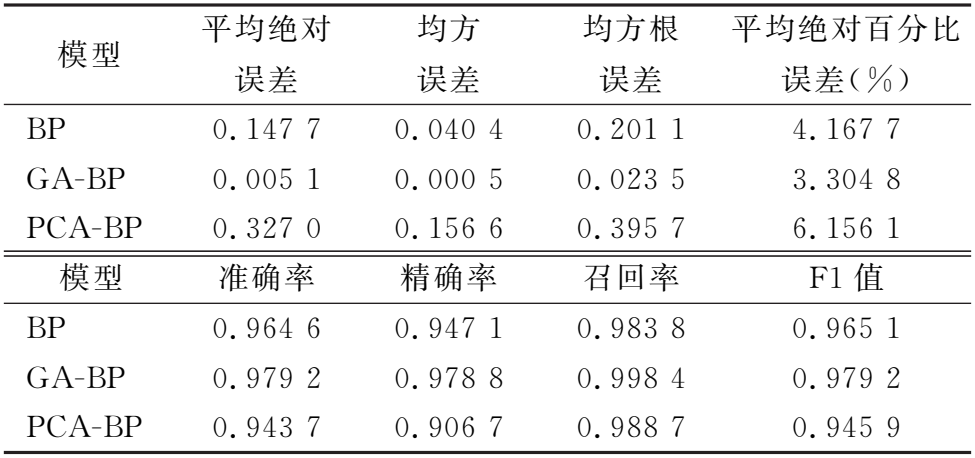
模型 平均绝对 误差 均方 误差 均方根 误差 平均绝对百分比 误差(%) BP 0.1477 0.0404 0.2011 4.1677 GA-BP 0.0051 0.0005 0.0235 3.3048 PCA-BP 0.3270 0.1566 0.3957 6.1561 模型 准确率 精确率 召回率 F1值 BP 0.9646 0.9471 0.9838 0.9651 GA-BP 0.9792 0.9788 0.9984 0.9792 PCA-BP 0.9437 0.9067 0.9887 0.9459
此外,对上述3个模型进行稳健性检验,通过在测试集输入数据中系统性添加不同水平的高斯噪声,模拟现实应用中可能遇到的数据扰动情况,从而评估3个模型的抗干扰能力和稳定性。具体而言,设置1%、5%、10%和20%四个噪声等级,在每个噪声水平下对测试集数据进行多次重复试验,通过计算各模型在加噪数据上预测准确率的平均值(见表5),定量分析其性能衰减程度和结果波动性。在4个等级噪声水平下,GA-BP模型的平均准确率均高于BP神经网络模型和PCA-BP神经网络模型,表明其预测结果更加稳定可靠。
表5 稳健性检验结果
Table 5 Robustness test results
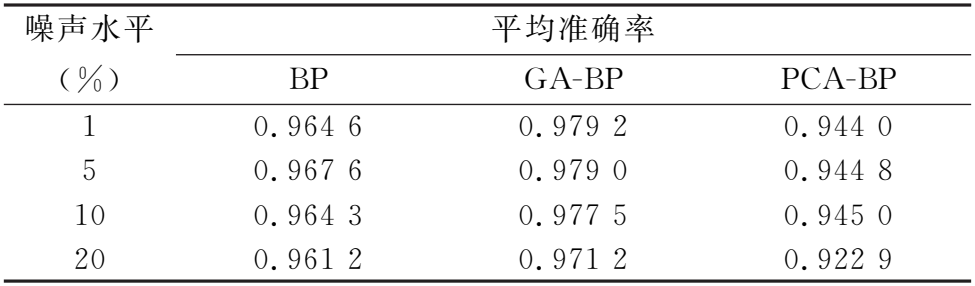
噪 声 水 平 ( % ) 平 均 准 确 率 B P G A - B P P C A - B P 1 0 . 9 6 4 6 0 . 9 7 9 2 0 . 9 4 4 0 5 0 . 9 6 7 6 0 . 9 7 9 0 0 . 9 4 4 8 1 0 0 . 9 6 4 3 0 . 9 7 7 5 0 . 9 4 5 0 2 0 0 . 9 6 1 2 0 . 9 7 1 2 0 . 9 2 2 9
将经过预处理的6所大学2019—2024年发明专利样本数据输入GA-BP神经网络模型,共识别出高价值专利142 909件,其中研究型大学(RU)占69.4%,非研究型大学(NRU)占30.6%。结合筛选特征,进一步对识别结果展开多维分析(见图7),其中,高价值专利占比、C7与C10由于数据较大,参考主轴数据标签(左),C1、C3、C4、C8、C13、C14参考次轴数据标签(右)。
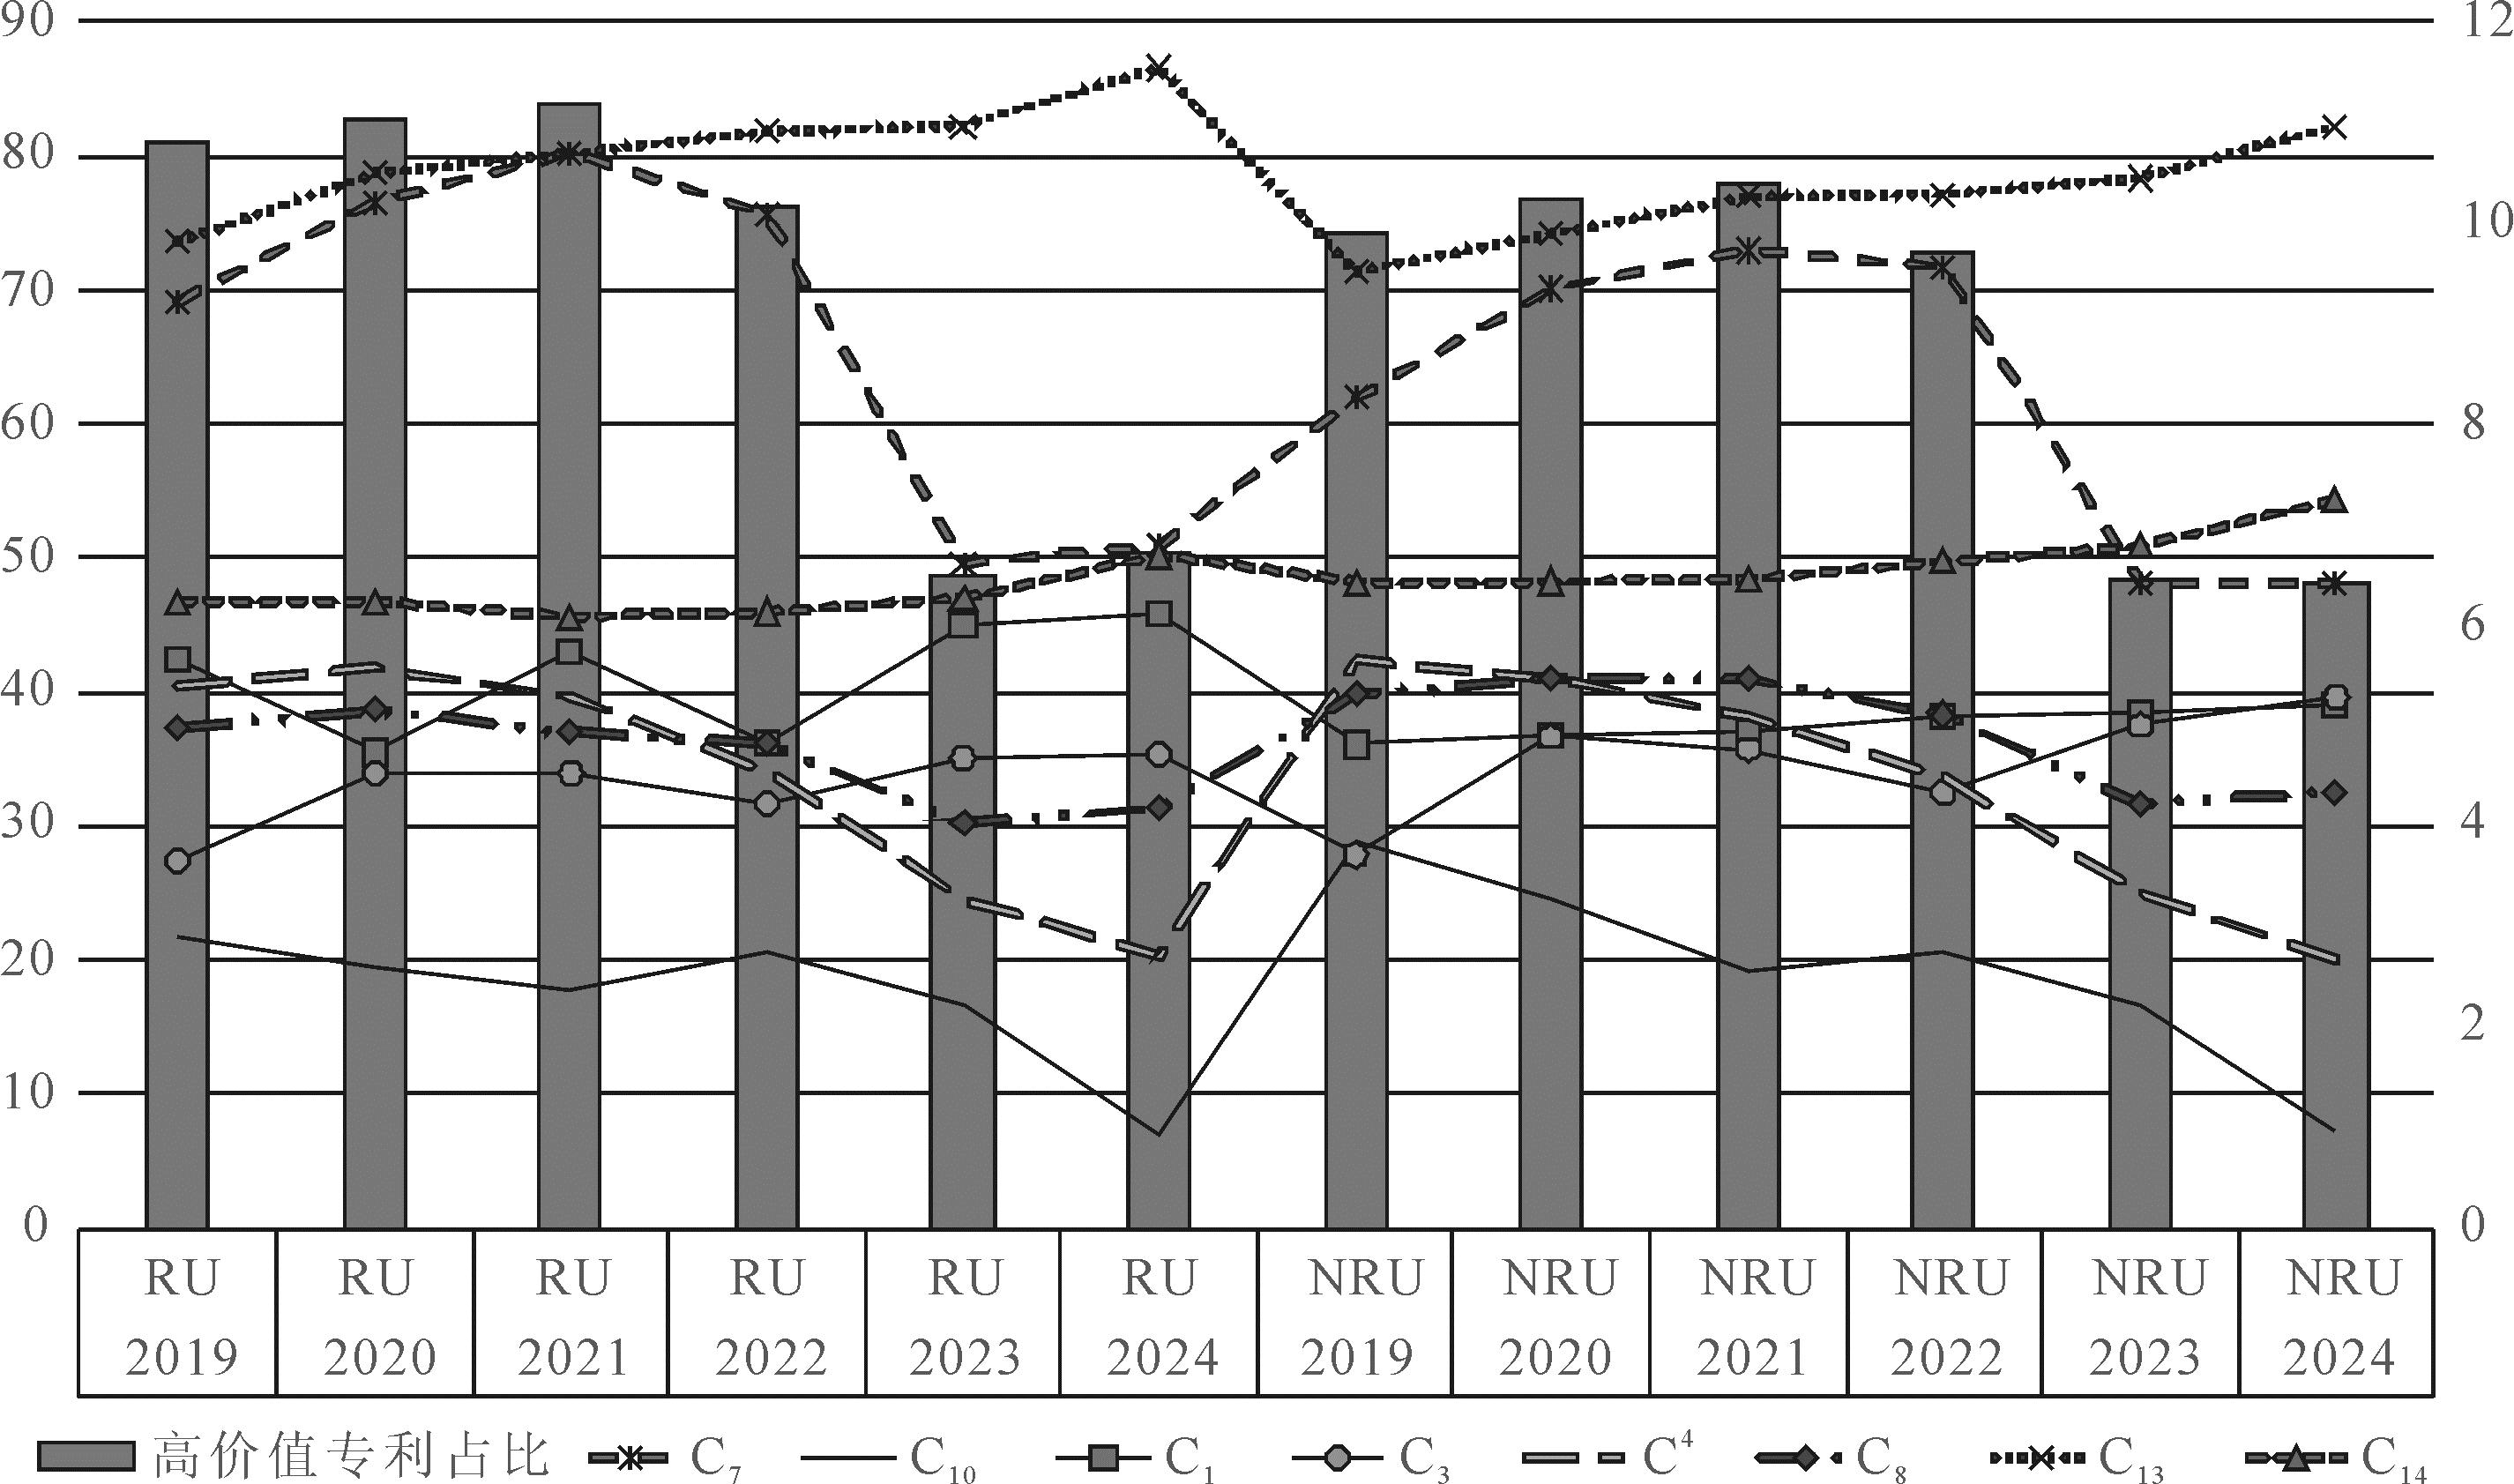
图7 高价值专利数据趋势
Fig.7 Trend of high-value patent data
(1)技术维度:①发明人规模作为研发组织模式的核心表征,研究型大学与非研究型大学呈现显著不同。研究型大学高价值专利发明人规模集中在3~9人区间,合计占比超过75%,其中4~7人中型团队占比最高,年均达32%,10人以上大规模攻关团队占比稳定在8%左右,单人独立研发专利占比不足3%。这表明,研究型大学依托学科交叉平台与国家级科研项目,更依赖中大规模团队协作,既能实现多领域知识互补,又能支撑复杂技术创新,单人或超大规模团队均非主要模式。非研究型大学高价值专利发明人规模集中在3~5人区间,占比超过82%,单人专利占比约5%,10人以上团队占比不足1%,团队规模偏小且结构单一,以小范围精研为主,侧重应用型技术类小规模协同创新,缺乏跨学科大团队支撑。②联合专利分类号方面,研究型大学高价值专利均值约为4.78、非研究型大学约为5,表明非研究型大学在应用牵引下多采用“多模块组合式”技术方案,而研究型大学则在核心技术领域做深做透、以关键技术突破带动价值创造。③技术影响力方面,研究型大学高价值专利均值约为5.62,非研究型大学约为5.51。研究型大学在高端影响力方面更占优势,16次以上占比约为2.45%(非研究型大学约为1.87%),表明研究型大学更容易形成外部知识扩散与跟随创新。校际层面,清华大学(均值5.88)、浙江大学(5.77)构成影响力第一梯队,东南大学(5.02)相对偏弱,表明其高价值专利更可能来自“应用落地/细分突破”而非高频引证扩散。
(2)法律维度:①专利有效性体现为专利法律的稳定性,研究型大学高价值专利有效状态占比超过85%,审中专利占比约为10%,失效专利占比不足5%,说明专利法律稳定性较强,专利申请质量与布局规范。非研究型大学有效专利占比约为70%,失效专利占比达22%,审中专利占比8%,说明专利法律稳定性较弱,部分专利因技术落地性不足、权利要求撰写瑕疵导致提前失效,法律保护持续性薄弱。②首权字数方面,非研究型大学均值高于研究型大学,且“>1 000字”占比更高,表明非研究型大学在高价值专利形成上偏向“通过更细化的权利要求布局来增强专利保护性”,但也可能带来撰写成本与审查负担。清华大学首权字数最低,呈现表达凝练与边界聚焦的特征;浙江工业大学与东南大学侧重通过细化技术特征来增强专利权利的实质性覆盖与稳定性。③审查时长方面,研究型大学高价值专利明显短于非研究型大学,且研究型大学高价值专利审查时长小于等于12个月占比约为41%;非研究型大学约为29.3%,且非研究型大学高价值专利审查时长大于36个月占比更高。这意味着研究型大学在审查时长、申请文本质量和既有技术壁垒可识别度方面更具有效率优势。浙江大学审查时长均值最短,体现出其拥有成熟的申请与审查沟通能力;浙江工业大学与江苏大学偏长,权利要求更复杂、审查往复更频繁。
(3)经济价值维度:①产业覆盖宽度方面,研究型大学高价值专利均值略高于非研究型大学,且研究型大学在“11~15个”及“16个及以上”两个高覆盖区间占比更高,表明其高价值专利更容易形成“多产业可迁移”的技术外溢;非研究型大学在“6~10个”区间占比更高,体现出更聚焦的应用场景拓展。②技术功效上,非研究型大学均值高于研究型大学,且“10个及以上”占比略高,说明非研究型大学高价值专利往往以“更丰富的功能点/应用收益描述”来支撑价值实现,而研究型大学高价值专利更偏向以核心机理/关键突破带动价值的表达逻辑。
综上所述,研究型大学高价值专利优势集中在“技术影响力上限更高、审查效率更优、产业外溢略强”,并呈现出“中等规模协作+相对凝练文本”的稳态创新范式;非研究型大学则更突出“更长的首权文本、更丰富的功效表达”,体现出以工程化集成和应用化叙事推动高价值识别与保护的路径。
本研究围绕研究型大学高价值专利识别这一核心问题,构建融合遗传算法与BP神经网络的高价值专利识别模型,并以清华大学等6所高校专利数据为样本进行检验,得出如下结论:第一,运用遗传算法与粗糙集理论进行特征约简,最终筛选出发明人规模、联合专利分类号、技术影响力、专利有效性、首权字数、审查时长、产业覆盖宽度、技术功效8个关键特征来表征专利价值的多维信息,显著提升了模型识别效率与可解释性。第二,GA-BP神经网络模型在准确率、稳健性等方面均优于标准BP神经网络模型与PCA-BP神经网络模型,验证了“全局寻优+局部微调”策略在高价值专利识别中的有效性。第三,对6所大学高价值专利进行分析发现,研究型大学高价值专利在技术影响力上限、审查效率、产业覆盖宽度等方面具有明显优势。而非研究型大学高价值专利则呈现出“更长首权文本、更丰富技术功效表达”的特征,偏向以工程化集成与应用化叙事支撑价值实现。
(1)丰富了研究型大学高价值专利评价指标体系。本研究在初选指标的基础上,引入校企合作强度、审查时长、交易次数、技术功效等指标,契合大学专利产学研协同与转化导向的实践逻辑。同时,通过特征约简验证CPC分类号相较于IPC分类号在揭示专利应用场景与市场潜力方面的优势,为后续高校专利价值评估提供了更具解释力的指标参考。
(2)拓展了专利价值识别方法。针对现有机器学习模型在专利分类中存在特征冗余、参数经验依赖等问题,本研究探索“遗传算法+粗糙集特征约简”与“遗传算法优化BP神经网络初始参数”的双重优化路径。该方法不仅对输入特征进行精简降维,还通过全局搜索改善了神经网络的收敛起点,形成从特征筛选到模型训练的系统性优化框架。与PCA降维方法相比,GA-BP模型在保留原始特征信息的前提下实现性能更优,表明该方法在专利价值识别领域的适用性与先进性。
(3)深化了对研究型大学高价值专利形成机理的认知。通过对比研究型大学与非研究型大学高价值专利特征差异,发现两类高校在创新模式、文本撰写策略、审查效率等方面不同。其中,研究型大学更倾向于“技术深耕+团队协作+凝练文本”的范式,而非研究型大学则偏向“应用集成+功效丰富+细密权利要求”的路径。这为理解不同层级高校专利价值生成机制提供了新视角,也为分类制定专利质量提升策略提供了基础。
(1)技术维度:优化团队协作机制,强化技术影响力。高校应组建学科互补的研发团队,依托交叉平台推动核心技术攻关。对引证强度高的专利给予长期资源倾斜,保护其科学价值与知识扩散潜力。同时,重视联合专利分类号所反映的应用场景广度,引导科研人员在核心技术领域深耕细作,避免“多模块简单组合”式低效创新,提升专利技术复杂度与产业适配性。
(2)法律维度:提升专利申请文本质量,善用审查政策工具。高校知识产权管理部门应前置介入研发过程,指导科研团队开展充分的可专利性检索,优化独立权利要求撰写策略——既要避免字数过多导致专利保护范围过窄,也要防止过度简略而影响授权稳定性。对于技术复杂或审查争议较多的专利,建立跟踪应对机制;对关键核心技术积极运用优先审查、快速审查通道,缩短市场等待时间。同时,加强专利权利管理,对法律稳定性强的专利予以持续投入,降低失效风险。
(3)经济维度:拓展转化渠道,构建多元化运营模式。高校应转变“重申请、轻运营”的观念,依托技术功效与产业覆盖宽度,识别具有多产业迁移潜力的高价值专利,通过探索开放许可、专利池等模式促进技术扩散。针对校企合作专利占比较低的现状,主动对接产业需求,建立“企业出题、高校答题”的联合研发机制。丰富专利交易形式,在转让基础上加强许可、质押、作价入股等多元化运营,通过追踪交易数据动态调整转化策略,系统提升专利市场化活力。
(4)高校应实施差异化学科与院校支持策略。各高校应根据自身学科优势与专利特征短板,制定针对性改进措施。例如,对技术影响力偏弱的高校,可加大基础研究投入与高水平论文发表激励;对审查时长偏长的高校,应重点提升专利申请文本质量与审查沟通能力。在资源配置与绩效考核中,不宜采用“一刀切”的唯专利数量指标评价体系,而应引入以技术影响力、审查效率、产业覆盖等为核心的质量导向型评价体系。
本文存在如下不足:①初选专利特征指标体系受专利信息难以获取和数据量化难度高的影响,在特征指标选取方面存在一定不足。未来可增加数据来源和采用新的指标量化方法,来增强数据的全面性和准确性。②验证了GA-BP神经网络在测度高校高价值专利方面的有效性与优越性,但对不同学科领域特征差异的分析较少。未来可按技术领域进行细分,探究学科差异的影响。③主要选取6所大学为研究样本,未来可扩大样本数量,通过对比分析,提高研究结论的普适性。
[1] 李睿,周维,容军凤,等.高价值企业专利的被引特征分析——以世界500强企业专利为例[J].情报学报,2015,34(9):899-911.
[2] 周小琴,蔡鸿宇,石进,等.融合专利SAO特征的早期专利价值评估方法研究[J].情报杂志,2024,43(10):176-186.
[3] WEI T, LIU T. Evolution of high-value patents in reverse innovation: focus on Chinese local enterprises[J].Mathematical Problems in Engineering, 2020, 1: 8127096.
[4] 孙笑明,熊旺,宇文乐薇,等.高校与科研院所沉睡专利价值评估[J].科技进步与对策,2025,42(6):99-108.
[5] 文豪,胡晓阳.基于质量评价模型的专利质押价值评估体系修正研究[J].科技管理研究,2022,42(21):168-175.
[6] 张寒,李正风,张凤.研究型大学如何服务高水平科技自立自强——基于20所“双一流”建设高校的扎根分析[J].科技进步与对策,2024,41(23):1-10.
[7] 周光礼,杨晓薇.高水平研究型大学:概念模型、指标体系与综合评价[J].北京大学教育评论,2025,23(3):96-112,189-190.
[8] 许赞,孔祥浩,魏静.我国研究型大学学科创新能力聚类分析——以36所“985”工程高校为例[J].科技进步与对策,2014,31(23):165-168.
[9] FAN S Q, LIU G X, TU Y, et al. Improved multi-criteria decision making method integrating machine learning for patent competitive potential evaluation:a case study in water pollution abatement technology[J]. Journal of Cleaner Production,2023,403: 136896.
[10] LIU W D, LI S, CAO Y, et al. Multi-task learning based high-value patent and standard-essential patent identification model[J]. Information Processing &Management, 2023,60(3): 103327.
[11] GRIMALDI M, CRICELLI L, ROGO F. Valuating and analyzing the patent portfolio: the patent portfolio value index[J]. European Journal of Innovation Management,2018, 21(2):174-205.
[12] ZHOU G, TONG Y, WANG H. Analysis of key features of high-value patent based on LASSO-Logit[J]. Financial Engineering and Risk Management, 2023, 6(3): 87-95.
[13] 张黎,李倩,禹建丽.基于犹豫模糊软集的专利质量评价模型[J].科技促进发展,2018,14(5):440-446.
[14] 姜南,李逸凡,刘谦,等.专利转化特征精准识别与预测——以人工智能芯片为例[J].科技进步与对策,2022,39(10):1-10.
[15] HARHOFF D, SCHERER F M, VOPEL K. Citations, family size, opposition and the value of patent rights[J]. Research Policy,2003,32(8):1343-1363.
[16] 李睿,范九江.高校专利可转化性与其文献计量特征相关性研究[J].科技进步与对策,2021,38(17):43-50.
[17] 廖佳佳,高菲,吕良.联合专利分类体系研究[J].现代情报,2014,34(1):64-68.
[18] 邓思铭,栾春娟.专利技术会聚层次对专利市场价值的作用机理研究[J].科技进步与对策,2025,42(15):149-160.
[19] LEE J, SOHN SY. What makes the first forward citation of a patent occur earlier[J]. Scientometrics, 2017, 113(1): 279-298.
[20] HALL B H, JAFFE A, TRAJTENBERG M. Market value and patent citations[J]. The Rand Journal of Economics, 2005, 36(1): 16-38.
[21] 万小丽.专利质量指标中“被引次数”的深度剖析[J].情报科学, 2014,32(1):68-73.
[22] HALL B H, MACGARVIE M. The private value of software patents[J]. Research Policy, 2010, 39(7): 994-1009.
[23] 肖莉娜,杨武,刘明珠.基于专利价值视角的产业竞争优势测度与比较研究——以5G移动通信产业为例[J].中国科技论坛,2025,41(11):55-63.
[24] GAMBARDELLA A, HARHOFF D, VERSPAGEN B. The value of European patents[J]. European Management Review, 2008, 5(2): 69-84.
[25] 李兰花,黄灿,郑素丽,等.实物期权视角下技术市场特征对高校专利维持决策的影响研究[J].管理工程学报,2021,35(2):79-89.
[26] SCHANKERMAN M,PAKES A.Estimates of the value of patent rights in European countries during the post-1950 period[J].The Economic Journal,1986,96(384):1052-1076.
[27] ZHANG Y, QIAN Y, HUANG Y,et al. An entropy-based indicator system for measuring the potential of patents in technological innovation: rejecting moderation[J]. Scientometrics,2017, 111: 1925-1946.
[28] CHEN X, QIU Y. MBCA: Identification of high-value patents using deep learning based language understanding[C]. Proceedings of the 2023 2nd international conference on algorithms, data mining, and information technology. New York: Association for Computing Machinery, 2023.
[29] LIU C,SHI Y,XIE WJ,et al.A novel approach to screening patents for securitization: a machine learning-based predictive analysis of high-quality basic asset[J].Kybernetes,2023,53(2):763-778.