开放科学(资源服务)标识码(OSID):
Drawing on open innovation theory and the knowledge production function, this study develops an analytical model linking heterogeneous participant behavior to project-level innovation outcomes. Users enhance problem articulation and market relevance, while developers improve technical depth and iterative efficiency. The study posits that while user-developer interaction fosters synergistic knowledge recombination, excessive heterogeneity may increase coordination costs. Empirically, the study analyzes a panel of 3.98 million GitHub projects (2009-2025), identifying AI-related initiatives via domain classification. Innovation performance is measured by star growth, fork activity, and sustained contributions. Core explanatory variables quantify user engagement through issue submissions and feedback interactions, and developer participation through active contributors and commit frequency. The empirical strategy employs fixed-effects regression models to control for unobserved project heterogeneity, complemented by robustness checks incorporating lagged variables and instrumental variable approaches to mitigate potential endogeneity concerns.
The empirical results reveal several critical findings. First, both user participation and developer engagement significantly enhance innovation performance, but their functional roles differ markedly: user demand exhibits approximately threefold greater impact than developer supply in AI-specific projects (coefficients: 0.258 vs. 0.066), underscoring the dominance of demand-pull mechanisms in data-driven innovation. Second, the interaction between users and developers exhibits an inverted-U relationship: within moderate ranges, participation generates complementary effects, but when both reach high levels simultaneously, a significant negative interaction emerges, indicating a "crowding effect" where coordination costs outweigh synergistic benefits—a manifestation of the "openness paradox". Third, heterogeneity analysis demonstrates that these effects are attenuated by technical complexity (programming language count), which increases coordination frictions, and moderated by license restrictiveness, which enhances developer incentives but impedes user participation. AI open-source projects show stronger demand-pull and supply-driven effects than other sectors, with demand-pull being more pronounced. NLP and multimodal projects exhibit higher demand sensitivity than computer vision, while developer supply benefits multimodal most, reflecting data-driven and scenario-driven characteristics.
This study contributes to the literature in several respects. First, it advances open innovation research by shifting the analytical focus from firm-level boundary management to ecosystem-level actor interaction within the context of AI technological paradigms. Second, by employing large-scale digital trace data, it improves empirical identification and external validity beyond small-sample case studies. Third, it extends the knowledge production framework to digital collaborative environments, demonstrating how heterogeneous inputs interact under conditions of technological complexity. Finally, the findings provide policy implications for digital innovation governance, suggesting that platform operators and policymakers should design institutional mechanisms that balance participation incentives, reduce coordination frictions, and enhance collaborative efficiency in AI ecosystems.
开放科学(资源服务)标识码(OSID):
开源创新已逐渐成为推动技术进步与产业升级的重要力量,也为重塑全球人工智能创新生态格局提供了关键机遇[1]。开源创新在新一代人工智能技术生态建设中的作用日益凸显,2017年国务院印发的《新一代人工智能发展规划》提出,“促进各类通用软件和技术平台的开源开放”;2025年国务院发布《关于深入实施“人工智能+”行动的意见》强调,支持人工智能开源社区建设,促进模型、工具、数据集等汇聚开放,培育优质开源项目。在企业与社区实践层面,以DeepSeek、通义千问等为代表的人工智能开源项目通过开放底层算法、构建开放社区,显著提升研发效率与技术可及性,有力促进了“智能平权”的实现[2]。由此可见,开源创新已从技术工具升级为人工智能产业生态的共创平台,对突破核心技术瓶颈、实现产业化落地具有重要意义[3]。
相较于传统创新理论强调技术创新在创新绩效中的主导作用[4],开放式创新理论认为有目的的知识流入与流出均能加速创新过程[5]。这为理解开源创新作用提供了重要分析框架。在开源环境中,用户与开发者分别扮演知识需求方与供给方,二者互动共同驱动创新产出。其中,在具有显著网络外部性的开源情境下,用户需求发挥关键的拉动效应。人工智能领域的模型优化高度依赖数据资源驱动,单纯的代码开放难以保障开发者的持续贡献[5],需要用户反馈提供的优化作用。同时,由于人工智能开源项目的许可证设计涉及商业化风险与衍生项目合规性,不同类型许可证的代码使用与分发权利存在差异,从而对开源项目创新绩效产生不同影响。由此可见,开源创新不仅是需求与供给间的动态互动过程,而且会受到治理机制影响,这为深入探讨开源项目创新绩效形成机制提供了独特的研究情境。
本文使用Python网络爬虫法,通过GitHub官方API获取2009-2025年共398万条开源项目数据,并基于开放式创新理论框架,重点回答三大核心问题:①用户需求和开发者供给对开源项目创新绩效有何影响?二者影响效果有何差异?②用户需求和开发者供给对开源项目创新绩效的作用是否受到技术复杂度与治理机制的调节影响?③人工智能领域的开源项目是否表现出差异化的供需驱动机制?
开源创新本质上是一种开放式创新模式,其核心在于通过资源共享、协作开发与价值共创,进而实现分布式知识生成与技术迭代。早期的开源理论研究多以开源软件开发实践为基础展开,如August等[5]比较了开源模式与传统封闭式开发模式之间的差异,强调开源开发依赖群体参与、去中心化、去模块化的协作机制,揭示了开源作为一种新型生产范式的制度逻辑与行为特征。随着数字技术扩散,学界对开源创新的关注逐步从软件开发延伸至更广泛的产业与技术场景。Benkler[6]强调开源不仅是一种技术开发方式,而且是基于公共资源的点对点生产模式,代表不同于市场与企业的第三类生产组织形式。国内学者指出,开源创新因其“开放性、协作性、创新性”三重特征,成为推动数字技术变革和产业系统重构的重要力量[7]。然而,现有研究尚未形成统一的概念界定,部分文献仍将其等同于开源软件开发,对其作为一种独立创新模式的理论归纳与概念凝练仍显不足[8-9]。温馨等[10]构建了“开发者—项目—社区—许可证”四大要素框架,基于协作机制、制度规制与商业模式等维度揭示开源创新的知识图谱、运行逻辑与研究边界。从产业和技术场景来看,开源创新的覆盖范围也持续拓展,逐渐渗透至生产制造、人工智能、教育医疗等多个领域[11]。李兰花等[12]以华为鸿蒙开源社区为案例,揭示了松散耦合结构下的开源网络如何通过跨时空协作提升项目质量。同时,也有研究将开源创新纳入宏观经济分析框架,利用大规模平台数据评估开源软件创新的经济价值[13]。上述研究表明,开源创新已经超越单一技术场景,逐步成为影响产业升级和经济增长的重要变量[14]。
现有的开源创新绩效研究可以分为两类:一类聚焦于开源社区层面。相关文献将开源社区视为典型的开放式创新平台,重点关注协同创新与知识共享过程中的运行机制。此类研究通常以开发者与用户交互为核心,认为平台成员存在结构多样性与地理多样性等关键网络特征,成员间的合作模式呈非正式、自由化特点,这有助于异质性资源整合与跨区域知识融合,从而提高创新产出[15]。另一类是对开源软件项目创新绩效的研究。这类研究源于开源运动在软件开发领域的实践。Linux、Android等标志性开源软件项目的成功,引发了关于开源项目创新产出的系统性讨论。由于国外的开源生态建立较早、开源软件项目更多,现有研究主要以国外开源软件项目为对象,并多以理论分析为主。早期学者通过结构化访谈与扎根理论相结合的方法,探索开源软件项目内部成员的知识共享机制,并构建了“供给推动—需求拉动”的知识共享理论模型,强调用户和开发者是影响开源软件项目创新绩效的两大主体[16]。同时,也有研究认为激励机制能够对开源项目创新绩效产生影响,通过准自然实验,发现财政激励在短期内能够激发开发者的创新活动,但长期可能挤出开发者的内在动机[17]。开源创新带来资源获取优势的同时,也可能引发资源应用障碍[18-19]。郭海等[20]基于开放悖论视角,发现参与广度、参与深度对开源项目创新绩效的影响均呈“U型”特征,这一结论对开源社区在平衡开放与保护之间的治理政策制定具有一定启发意义。
总体来看,既有研究在理论构建与实证检验方面均取得重要进展,为开源创新研究奠定了基础,但仍存在不足:第一,在研究方法方面,相关研究多依赖小样本回归或单一案例论证,缺乏大样本数据支持下的实证分析,难以刻画开源创新的普遍规律。第二,在研究视角方面,鲜有研究从参与主体特征角度分析其对开源项目创新绩效的影响,也未区分不同参与主体的影响,同时,对人工智能这一高复杂度、高资源依赖的开源创新机制研究仍相对不足。鉴于此,本文基于GitHub平台398万条开源项目的大样本数据,从用户需求与开发者供给双重视角出发,探讨其对开源项目创新绩效的影响路径,并引入技术复杂度与许可证限制度作为关键调节变量,深入分析不同技术特征与治理机制如何影响需求拉动与供给驱动效应。
开放式创新理论指出,企业或组织通过有目的的知识流入和流出加速内部创新。对于开源项目而言,用户和开发者分别扮演知识需求方与供给方角色,二者通过网络外部性共同促进项目的创新产出。同时,开放式创新的核心矛盾在于共享与保护之间的张力,即过度开放可能导致知识外溢、贡献动力不足,过度封闭则会抑制协同效应发挥。因此,开源项目需要通过知识治理机制在开放与保护之间取得平衡。
在人工智能时代,这一“开放悖论”表现得更为突出。与早期传统开源软件项目相比,人工智能开源项目呈现出三大显著特征:①技术迭代更迅速。人工智能项目更新周期短,用户反馈与模型迭代形成高度耦合[21],使得用户需求在创新过程中的作用愈发关键。②资源依赖程度更高。大多数传统开源软件项目仅需单个程序员理解代码、作出改进,但对于人工智能开源项目而言,即使模型代码和相关参数开源,开发者仍然需要高性能算力与海量数据才能实验开源模型[21],开发者供给的边际贡献受制于资源稀缺性。③治理约束更多元。人工智能开源项目涉及数据合规与商业化,使得许可证选择与治理机制更为复杂[22],同时,不同许可证在权利授予与限制程度上存在差异,会影响开发者激励与用户使用意愿。这些特征意味着人工智能时代开源项目的供需关系不仅是市场信号与开发者供给互动的结果,而且深受技术本身复杂程度与治理机制的共同影响[23]。因此,本文引入技术复杂度与许可证规制作为关键调节因素,揭示人工智能时代开源创新的特殊性,也回应开放悖论在新兴领域的现实挑战。
用户作为知识需求方,其行为活跃度反映了开源项目的社会关注度与潜在市场价值,构成项目持续演化的重要外部激励机制。基于网络外部性理论,用户群体扩大将增强项目对边际用户和潜在贡献者的吸引力,形成正向反馈,提升项目整体价值。在开源社区中,用户反馈、使用行为及需求偏好为项目优化创新提供了关键的迭代信息来源[7],有助于实现更精细化的功能优化与版本升级。用户关注度提升往往伴随更高的项目可见性与资源获取能力,推动形成基于规模与信息溢出的良性循环。同时,人工智能开源项目高度依赖海量数据支持,用户需求反馈数据将反哺模型训练,加速项目优化创新。因此,在具有显著网络外部性的开源环境下,用户需求水平提升有助于项目的创新产出。由此,本文提出如下假设:
H1:用户需求对开源项目创新绩效产生正向影响。
在开源创新体系中,开发者作为知识与技术的主要创造者和供给者,直接推动项目的持续演进与创新积累。根据开放式创新理论,组织越来越依赖外部主体以获取多元化知识,补充内部研发能力。开源项目中的开发者通过代码提交、漏洞修复与功能扩展等方式,为项目注入新的技术内容,提升项目功能复杂度与整体质量。这一过程为项目自身积累了创新资源,也显著增强了开源项目对潜在贡献者的吸引力,形成“开发者供给—参与扩展”的正向循环。此外,开发者常出于满足自身需求、追求“技术极客”的动机而进行主动创新[17],并在项目中自愿共享其成果。这一动力机制为开发者带来声誉积累、技能提升等私有收益,也通过知识共享与示范效应推动整个社区协同创新。随着开发者数量和参与强度提升,知识供给呈现明显的规模效应与溢出效应,进而在集体层面提升开源项目创新绩效。综上,本文提出如下假设:
H2:开发者供给对开源项目创新绩效产生正向影响。
技术复杂度是指技术系统中技术组件与子系统间因非线性相互作用而形成的动态特征[24]。技术复杂度对自主创新具有调节作用,在开发式学习和探索式学习对企业创新绩效的影响中表现出抑制效应[24]。开源项目的复杂性主要体现在项目架构、开发语言、算法等方面。开源项目技术复杂度越高,意味着项目架构更复杂、语言种类更多、模块依赖性更强。一方面,高技术复杂度增加了用户与开发者的知识学习成本和知识转化难度[25],导致用户需求难以有效内化为创新输入;另一方面,高技术复杂度提高了技术协作门槛,削弱了外部技术开发者参与性,导致其难以理解项目代码结构、把握开发逻辑与提供实质性贡献。
值得注意的是,在人工智能这一高技术领域,开源项目常伴随对算法、高性能算力和海量数据的依赖问题,显著提高开发者协作门槛,同时,人工智能模型开发存在规模定律,相较于非技术社群,开发厂商掌握海量数据、算力、网络等资源[26]。因此,人工智能开源项目易形成“越开放,越难以持续发展”的发展困境,使得用户和开发者面对复杂项目时易产生退出或观望行为,从而对开源项目创新绩效产生负面影响。综上,本文提出如下假设:
H3a:技术复杂度削弱用户需求对开源项目创新绩效的正向影响;
H3b:技术复杂度削弱开发者供给对开源项目创新绩效的正向影响。
开源许可证协议是开源社区有力的治理机制[8]。不同许可证赋予参与者不同权利,从而影响知识流动程度。对于开发者来说,许可证的严格性能够保护原始贡献者利益,激励其持续投入核心功能研发工作。严格的许可证有助于保护开发者贡献的再利用权利[25]。如General Public License(GPL)许可证要求衍生工作保持开源,从而鼓励开发者更放心地进行深度研发。科学合理的许可证设计能够在开放与保护之间提供分层治理,促使开发者基于核心贡献享有应有权益。然而,对于用户来说,许可证规制可能会限制应用场景下使用或商业化该项目的便捷性,增加用户决策成本。严格的许可证还可能导致商业用户对接入外部开源组件的风险预期上升,从而选择规避或替代方案,制约用户的商业化应用意愿。
在人工智能时代,许可证规制的重要性进一步凸显。与传统软件的开源项目相比,人工智能开源项目通常涉及模型权重、训练数据与算力环境的共享,这不仅关系到代码复用,而且牵涉数据合规与商业应用风险[27]。严格的许可证规制可能对用户特别是商业用户形成较高的进入壁垒,从而限制外部需求转化。因此,在人工智能开源项目中,许可证规制既是技术治理工具,也是平衡创新激励与伦理合规的制度安排。总体而言,许可证规制会影响用户对开源项目使用成本和收益的权衡,对开源项目商业化与外部生态繁荣存在一定影响。因此,本文提出如下假设:
H4a:许可证规制增强开发者供给对开源项目创新绩效的正向影响;
H4b:许可证规制削弱用户需求对开源项目创新绩效的正向影响。
综合上述分析,本文构建研究框架如图1所示。
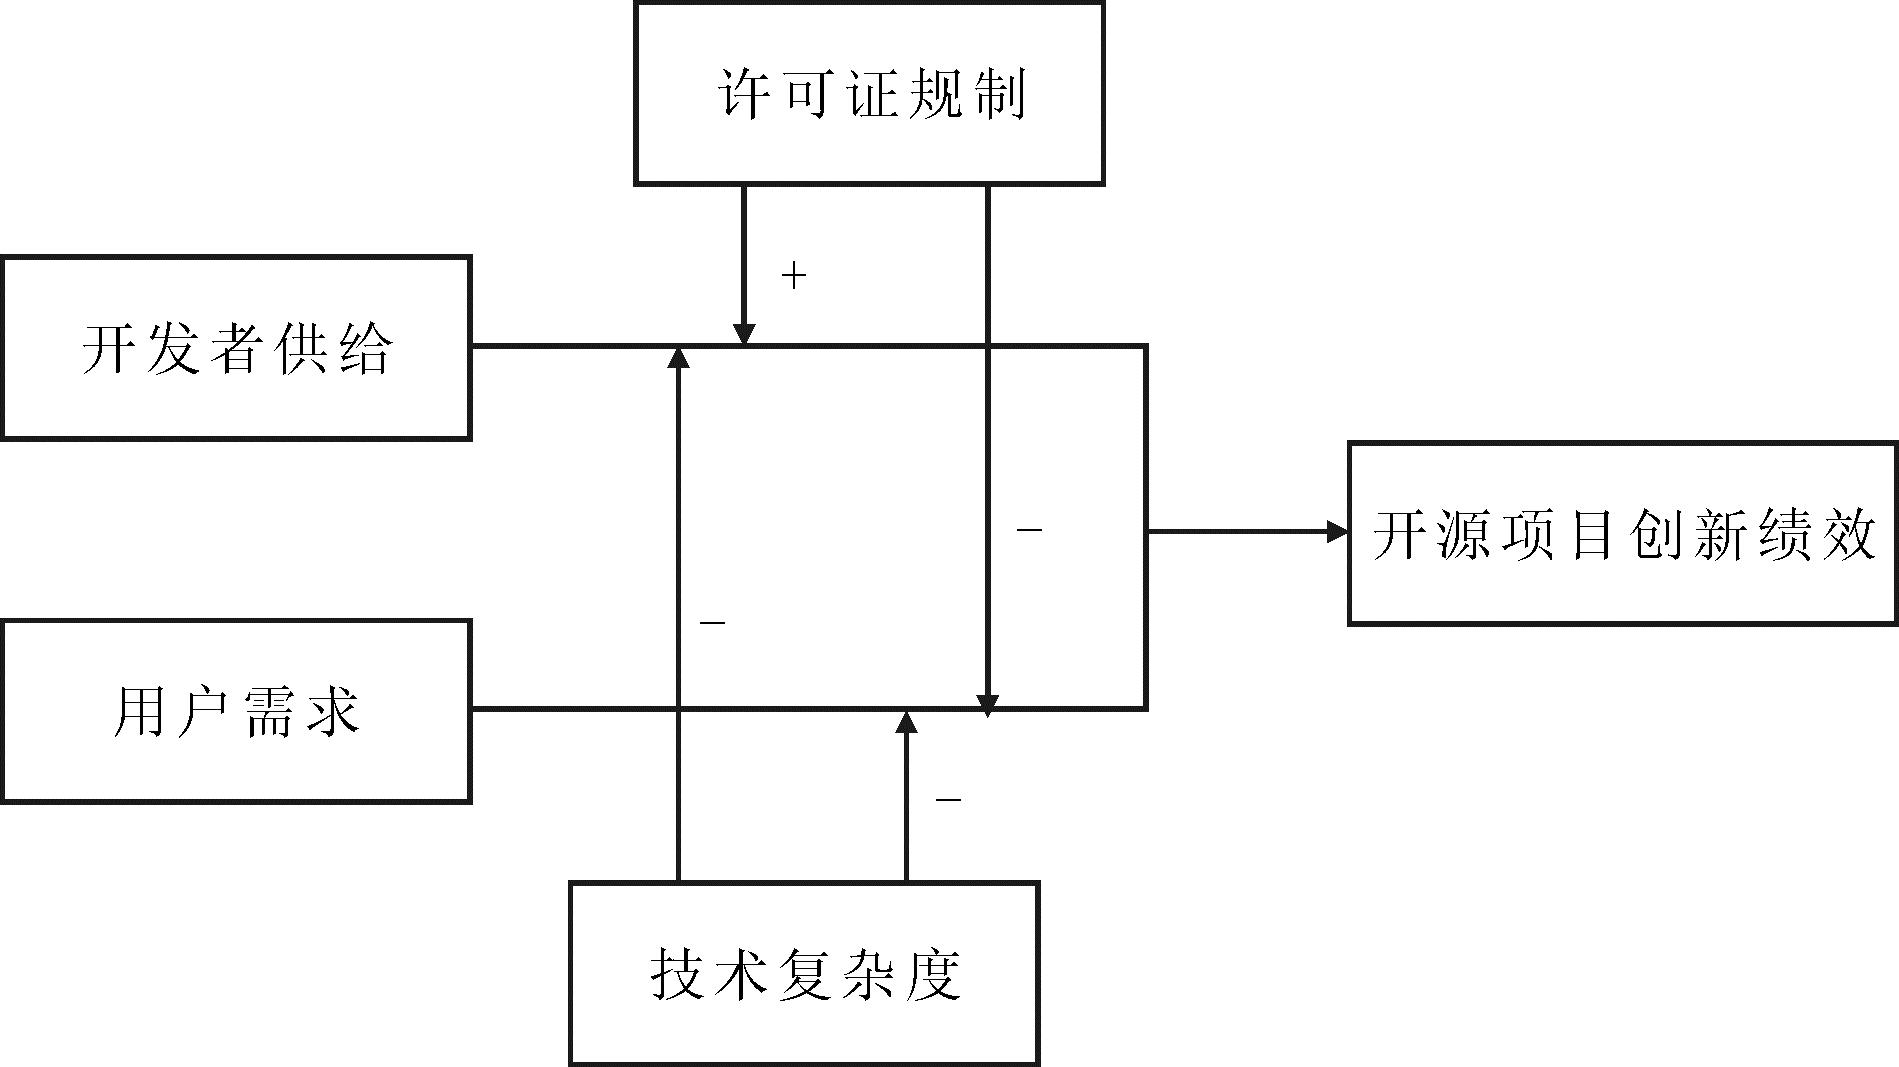
图1 研究框架
Fig.1 Research framework
本文选取全球最大的开源协作平台GitHub上的开源项目作为研究对象。GitHub成立于2008年,是当前全球最大、最活跃的开源协作平台,拥有超过1.5亿开发者、4.2亿个存储库。其庞大的用户基础和结构化的数据体系,为系统研究开源项目生命周期与可持续发展提供了权威、全面且具有可比性的数据基础。本文通过调用GitHub官方提供的RESTful API接口,系统抓取平台上2009—2025年间创建的公开代码仓库信息。原始数据以JSON格式存储,涵盖项目基本信息、开发活动、技术结构与治理属性等多个维度。本文使用Python进行数据解析与清洗,形成可用于实证分析的结构化数据集。
在数据预处理阶段,首先剔除非代码类仓库,以及缺少有效生命周期定义的无效记录(创建时间晚于最后更新时间)。其次,对存在极端值的变量进行1%水平的上下缩尾处理,以减少异常值对回归结果的干扰。最终获得可用于回归分析的开源项目样本共3 972 532条。
被解释变量为开源项目创新绩效。参考陈晓红等[15]的研究,采用开源项目的Stars数衡量开源项目创新绩效。Stars数表示用户对项目的关注或收藏数量,是社区成员最认可的综合反映项目受欢迎和创新程度的指标,且被广泛用来检索和标记项目[28]。为缓解极端值影响并降低变量分布偏态,本文对Stars数进行自然对数变换。
解释变量为用户需求与开发者供给。①使用watchers衡量用户需求。对于普通用户而言,可以通过订阅开源项目,进而关注开源项目更新情况,而watchers为订阅项目更新通知的用户数,能够反映项目持续受到关注的程度,因此可作为用户需求强度的代理变量。②参考李兰花等[26]、Sheoran等[27]研究,使用pull request和forks作为衡量开发者供给的指标。其中,pull request表示开发者向项目原始仓库提交代码修改请求,forks表示开发者通过复制项目仓库以进行独立开发。对于开发者而言,非项目创建者的开发者可以通过fork项目进入自己的仓库进行二次开发,同时,针对项目的优化开源提出pull request(合并请求),即将自己的代码合并到开源项目。前者体现对原项目的直接改进贡献,后者反映项目的潜在扩展性开发与技术溢出行为,二者共同刻画开发者供给能力与参与强度。此外,鉴于样本规模较大,不同项目间变量量纲及数值差异显著,本文对解释变量进行标准化处理,以消除量纲影响、提升数据可解释性。
调节变量为技术复杂度和许可证规制。第一,技术复杂度采用项目开发使用的编程语言种数衡量(languagecount)。开源项目通常由多种编程语言构成,语言种类越多,意味着系统架构更复杂、模块耦合程度更高[29],因此项目开发使用的编程语言种数可以在一定程度上表征技术复杂度。第二, 许可证规制(license)衡量的是开源协议对代码再使用、修改和商业化的约束强度,可以通过调节参与主体进入门槛、知识再利用路径,影响参与主体的进入成本与收益预期,从而对开源项目创新绩效产生异质性影响[30]。本研究采用虚拟变量测量许可证规制,其中,1表示有特定许可协议来规范开源项目开发及使用许可行为;0表示截至观测日开源项目还未选择任一种限制性许可证。
控制变量。参考郭海等[20]、陈晓红等[16]、李兰花等[26]的研究,选择的主要控制变量为话题标签数(topiccount)、项目生命周期(time_diff)、事件提交数(issues)、内存大小(diskusagekb)、权限开发者数(assignableusercount)。其中,项目生命周期为从项目的创建时间到开发者最后一次把代码提交并推送至远程仓库的间隔时间。它反映了该项目最新活跃时间,常用于评估项目活跃程度或是否已经停止维护。由于开源项目由不同编程语言构成,本文将主要的编程语言(primary language)进行编码分类后纳入模型进行控制,以消除不同类型编程语言的影响。
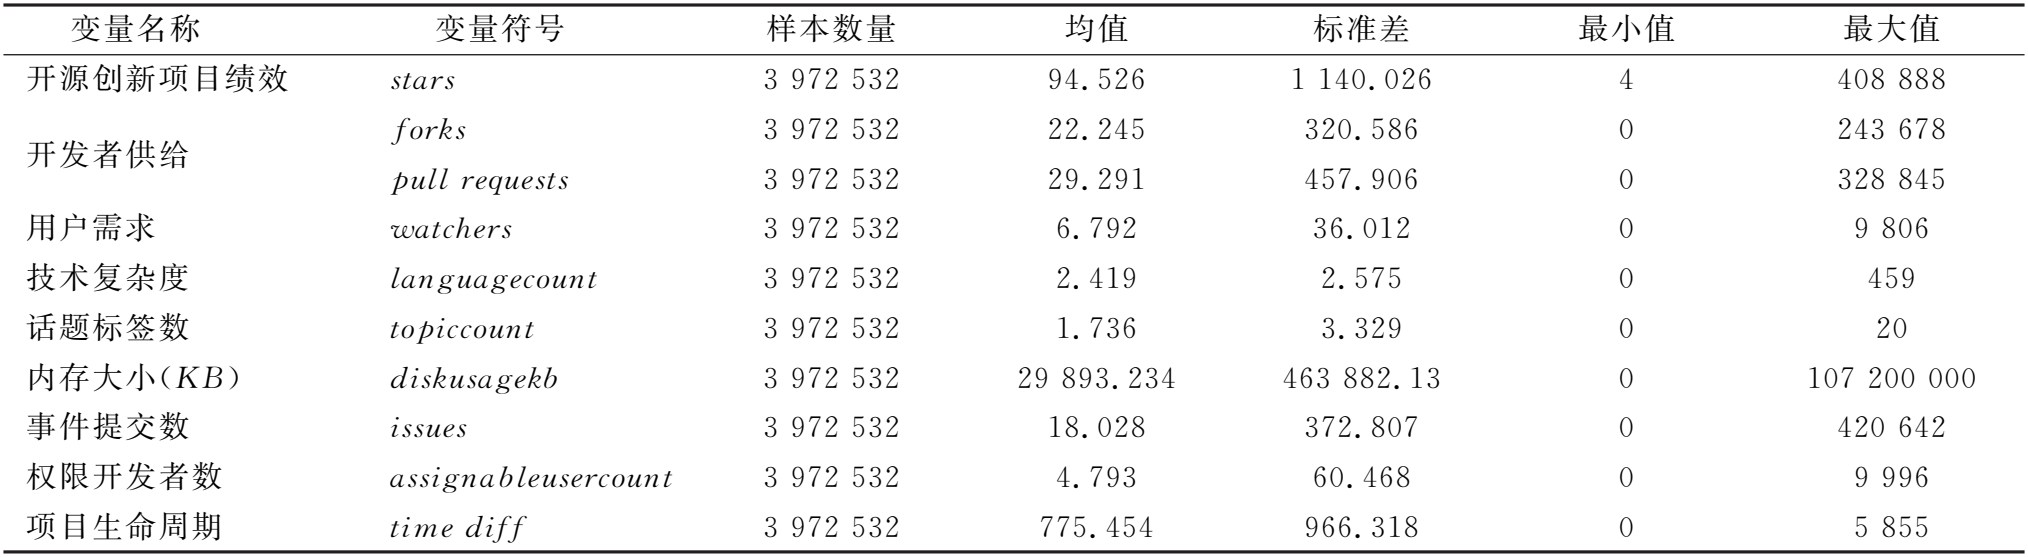
原始变量的描述性统计结果如表1所示。其中,Stars数均值为 94.526,但标准差高达 1 140.026,说明不同项目之间存在显著差异,呈现明显的长尾分布特征。核心解释变量方面,开发者供给(pull requests、forks)与用户需求(watchers)标准差均较大,表明开发者参与度与用户关注度在不同项目之间分布不均衡。控制变量中,事件提交数(issues)、内存大小(diskusagekb)以及项目生命周期(time_diff)等指标同样表现出较强异质性,反映出开源项目在资源投入规模、协作组织能力和发展阶段等方面存在明显差异。
表1 描述性统计结果
Table 1 Descriptive statistics
变 量 名 称 变 量 符 号 样 本 数 量 均 值 标 准 差 最 小 值 最 大 值 开 源 创 新 项 目 绩 效 s tar s 3 9 7 2 5 3 2 9 4 . 5 2 6 1 1 4 0 . 0 2 6 4 4 0 8 8 8 8 开 发 者 供 给 fo r k s 3 9 7 2 5 3 2 2 2 . 2 4 5 3 2 0 . 5 8 6 0 2 4 3 6 7 8 pu l l r e qu e s t s 3 9 7 2 5 3 2 2 9 . 2 9 1 4 5 7 . 9 0 6 0 3 2 8 8 4 5 用 户 需 求 wa t c he r s 3 9 7 2 5 3 2 6 . 7 9 2 3 6 . 0 1 2 0 9 8 0 6 技 术 复 杂 度 lan g ua g e c oun t 3 9 7 2 5 3 2 2 . 4 1 9 2 . 5 7 5 0 4 5 9 话 题 标 签 数 t o p ic c oun t 3 9 7 2 5 3 2 1 . 7 3 6 3 . 3 2 9 0 2 0 内 存 大 小 ( K B ) di s ku s a g e kb 3 9 7 2 5 3 2 2 9 8 9 3 . 2 3 4 4 6 3 8 8 2 . 1 3 0 1 0 7 2 0 0 0 0 0 事 件 提 交 数 i s s u e s 3 9 7 2 5 3 2 1 8 . 0 2 8 3 7 2 . 8 0 7 0 4 2 0 6 4 2 权 限 开 发 者 数 a s s ig n a b le u s e r c oun t 3 9 7 2 5 3 2 4 . 7 9 3 6 0 . 4 6 8 0 9 9 9 6 项 目 生 命 周 期 ti m e diff 3 9 7 2 5 3 2 7 7 5 . 4 5 4 9 6 6 . 3 1 8 0 5 8 5 5
为刻画用户需求与开发者供给对开源项目创新绩效的影响规律,本文基于分位数分箱方法对核心解释变量进行分组,并计算各组内开源项目创新绩效的条件均值,绘制非参数关系图。从图2、图3可以发现,无论是用户需求还是开发者供给,与开源项目创新绩效之间均呈现显著的递增关系。其中,低水平区间用户需求与开源项目创新绩效关系呈现较陡峭的上升趋势,表明在项目初始阶段用户反馈、关注与互动能够有效缓解信息不对称,提升项目可见度与资源吸引能力,从而促进创新产出。开发者供给与开源项目创新绩效关系表现出类似规律,即在开发者供给水平较低时新增开发者对开源项目创新绩效的促进作用尤为显著。非参数结果表明,供需因素均对开源项目创新绩效具有正向影响,但存在边际递减特征,为后续计量模型中检验非线性与协同机制提供了经验依据。
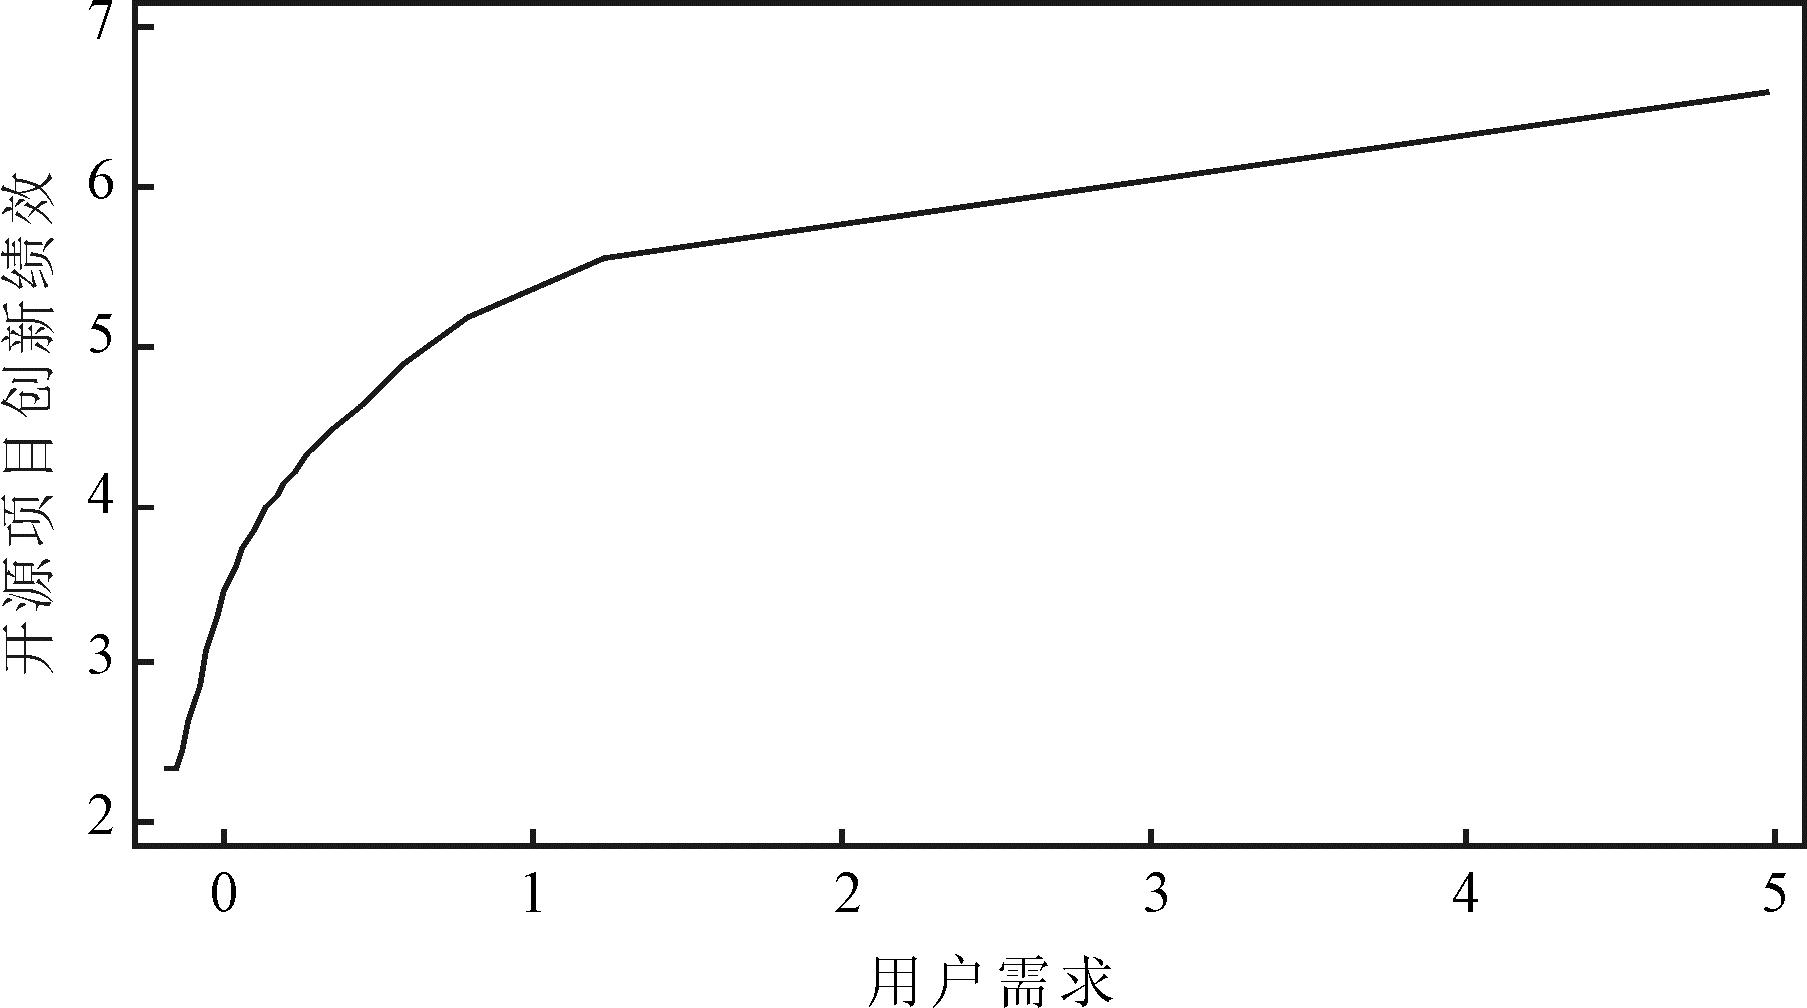
图2 用户需求与开源项目创新绩效的非参数关系
Fig.2 Nonparametric relationship between user demand and open-source project innovation performance
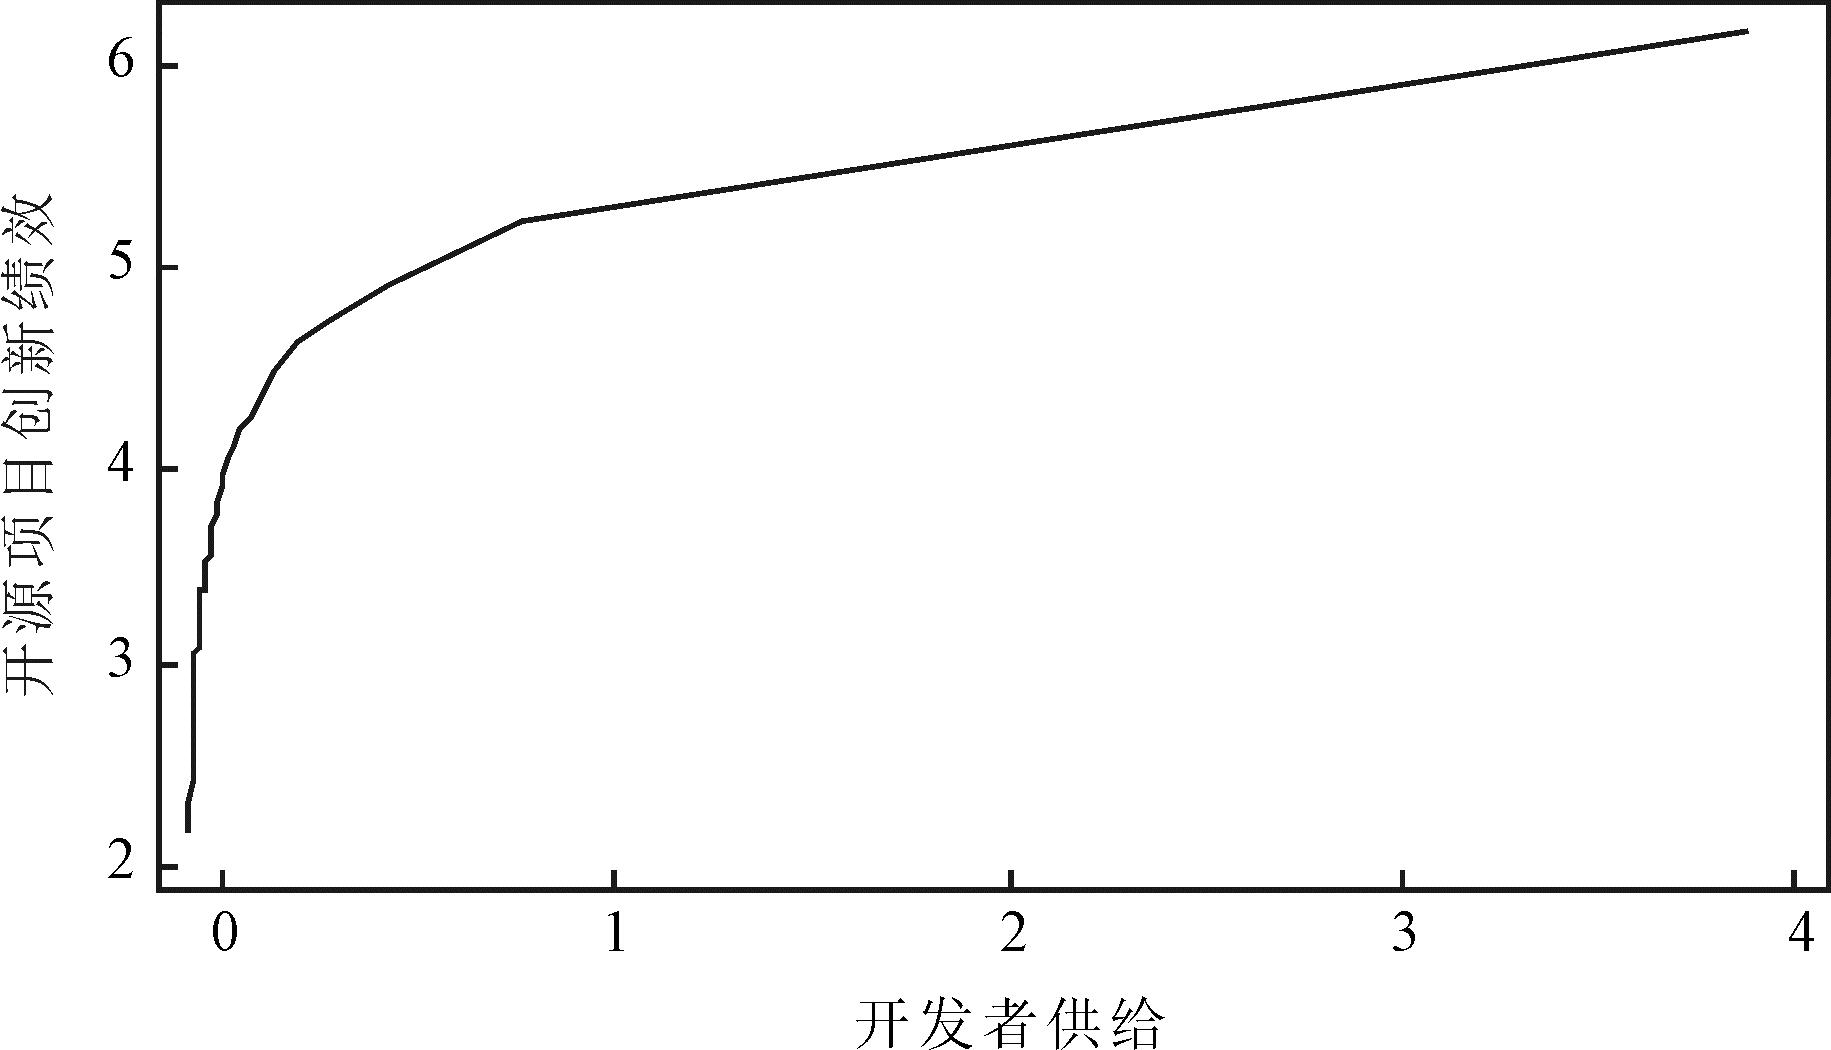
图3 开发者供给与开源项目创新绩效的非参数关系
Fig.3 Nonparametric relationship between developer supply and open-source project innovation performance
表2为用户需求与开发者供给对开源项目创新绩效的基准回归分析结果。列(1)仅纳入核心解释变量,结果表明,开发者供给对开源项目创新绩效的影响系数为0.107,用户需求的影响系数为0.305,两者均在1%显著水平上通过检验,支持了假设H1和H2。列(2)为加入话题标签数、项目生命周期等控制变量,核心解释变量的影响系数分别为0.064 9和0.244,系数有所下降但仍在1%水平上显著。同时,由于不同开源项目采用不同编程语言,为控制程序语言特征可能带来的系统性差异,本文根据项目的主要编程语言(primary language)进行分类编码并纳入回归模型。列(3)为加入编程语言固定效应的结果,可以发现,核心解释变量的显著性与数值保持稳定。
表2 基准回归结果
Table 2 Baseline regression results
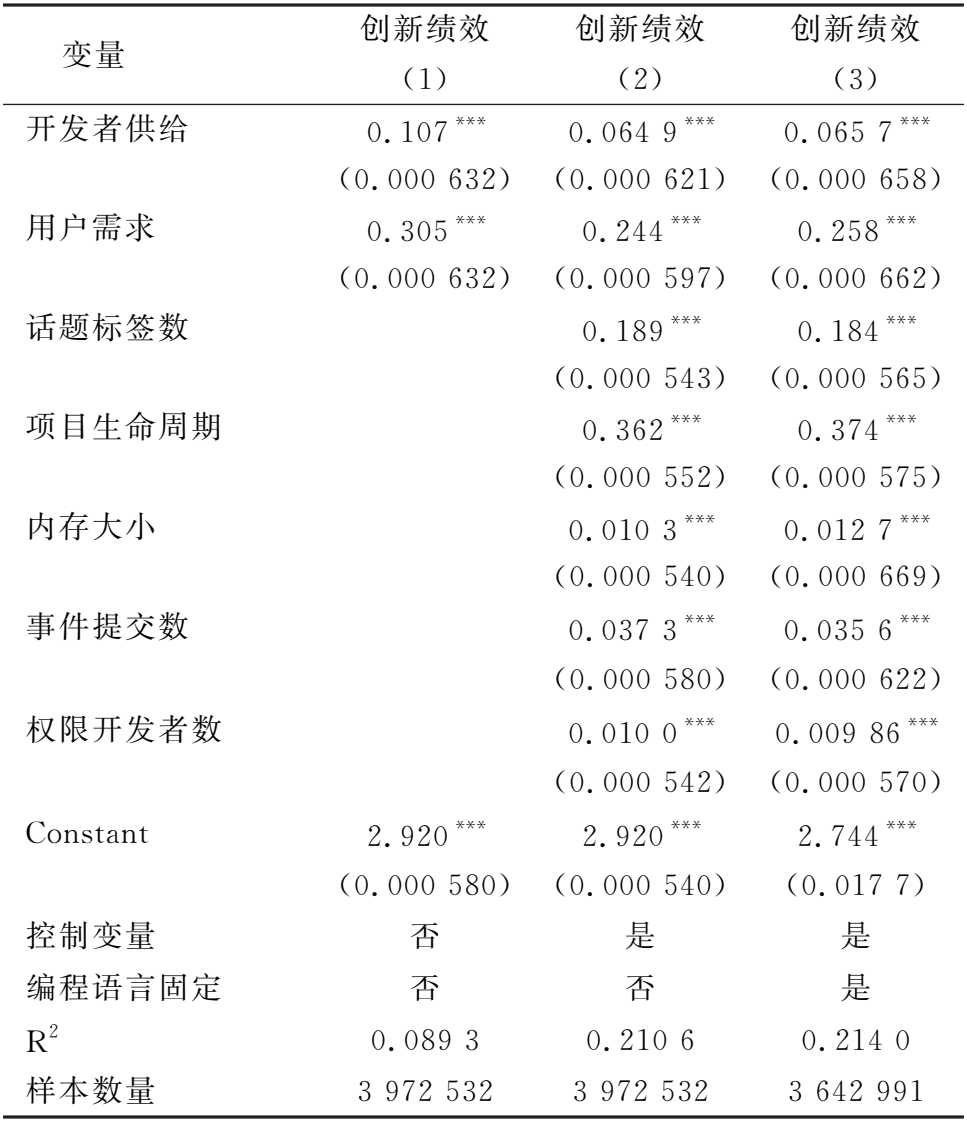
变量 创新绩效 创新绩效 创新绩效 (1) (2) (3) 开发者供给 0.107 *** 0.0649 *** 0.0657 *** (0.000632) (0.000621) (0.000658) 用户需求 0.305 *** 0.244 *** 0.258 *** (0.000632) (0.000597) (0.000662) 话题标签数 0.189 *** 0.184 *** (0.000543) (0.000565) 项目生命周期 0.362 *** 0.374 *** (0.000552) (0.000575) 内存大小 0.0103 *** 0.0127 *** (0.000540) (0.000669) 事件提交数 0.0373 *** 0.0356 *** (0.000580) (0.000622) 权限开发者数 0.0100 *** 0.00986 *** (0.000542) (0.000570) Constant 2.920 *** 2.920 *** 2.744 *** (0.000580) (0.000540) (0.0177) 控制变量 否 是 是 编程语言固定 否 否 是 R 2 0.0893 0.2106 0.2140 样本数量 3972532 3972532 3642991
注:***p<0.01, **p<0.05, *p<0.1,括号内为标准误,下同
从回归结果来看,用户需求对开源项目创新绩效的回归系数约为开发者供给的3倍,这一发现揭示需求拉动机制在开源创新中的主导作用。用户关注和参与不仅直接反映项目市场价值,而且通过网络外部性效应吸引更多用户加入,形成持续扩大的正向反馈循环[31]。
本文采用缩减样本、改变变量测度和替换核心解释变量的方法对模型进行稳健性检验,结果见表3。
表3 稳健性检验结果
Table 3 Robustness test results
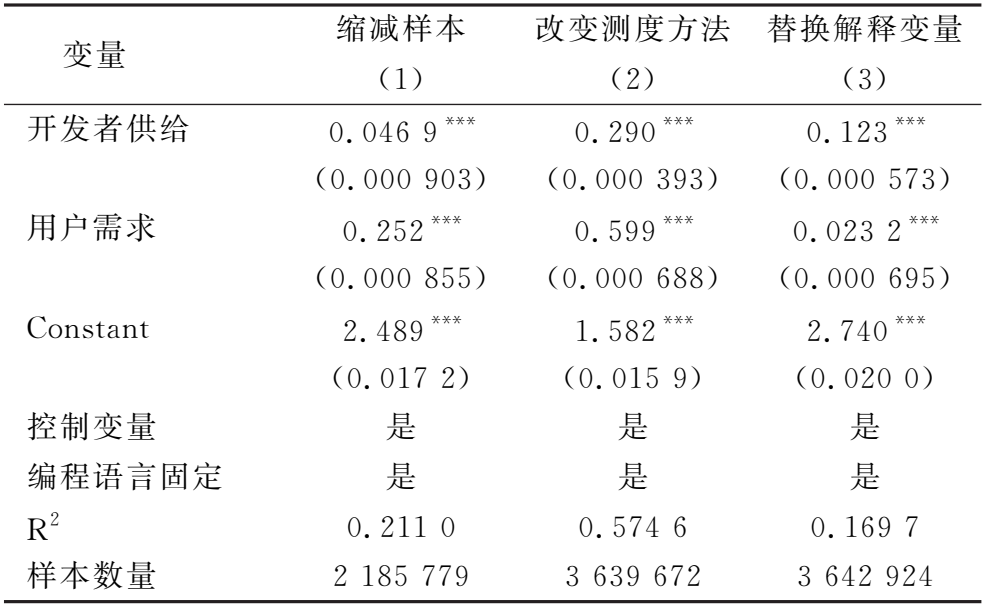
变量 缩减样本 改变测度方法 替换解释变量 (1) (2) (3) 开发者供给 0.0469 *** 0.290 *** 0.123 *** (0.000903) (0.000393) (0.000573) 用户需求 0.252 *** 0.599 *** 0.0232 *** (0.000855) (0.000688) (0.000695) Constant 2.489 *** 1.582 *** 2.740 *** (0.0172) (0.0159) (0.0200) 控制变量 是 是 是 编程语言固定 是 是 是 R 2 0.2110 0.5746 0.1697 样本数量 2185779 3639672 3642924
(1)缩减样本。为验证结果稳健性,考虑到主样本规模较大可能带来估计偏误,本文随机抽取样本总量的60%构成子样本,并在该子样本上重新估计模型。各主要解释变量依旧保持预期方向且均在1%水平上显著,与基准回归结果一致,表明模型具有稳健性。
(2)改变变量测度方法。为避免特定变量构造方式对结果的影响,采用对数变换方式重新测度核心解释变量。实证结果表明,经对数化处理后的变量系数方向与原模型一致,且均在1%水平上显著,说明估计结果不依赖于原有变量构造形式,进一步证明基准模型稳健性。
(3)替换核心解释变量。为进一步验证核心解释变量稳健性,本文采用替代指标重新进行测度。使用watchers的年度均值作为用户需求的替代变量,以更准确地反映社区用户对项目的持续关注与潜在使用意愿;同时,以pull request与issues的数量之和作为开发者供给的替代指标,从代码贡献与问题反馈两个维度衡量开发者的知识投入。结果显示,替代变量估计系数的方向与原结果一致且在1%水平上显著,进一步验证本文结论稳健性。
本文虽然在构建核心解释变量时采用了外生变量进行衡量,但开源项目创新绩效的提升对用户需求和开发者供给可能存在长期影响。此外,影响开源项目创新绩效的因素纷繁复杂,例如项目参数量、GPU需求量等均会直接影响开源项目创新绩效。囿于数据的可获得性,回归中难以穷尽所有控制变量,因此不可避免地存在遗漏变量所致的偏误问题。鉴于此,本文采用工具变量法缓解可能存在的内生性问题,进一步确保回归结果可靠性。
参考陈晓红等[15]、王京滨等[17]研究,通过对项目数据的综合分析,采用中国人工智能企业数(AIfirms)和滞后一期的GitHub社区年度用户均值(Avg_users)分别作为开发者供给与用户需求的工具变量。原因在于,我国人工智能企业高度依赖开源生态进行底层框架复用与模型发布,而人工智能产业规模扩张会显著促进企业开发者技术团队在GitHub等全球开源平台的协作创新,从而对平台层面的开发者供给形成系统性推动,但其并不会影响具体的开源项目创新绩效,单个项目创新绩效的增长主要由其项目质量、社区协作效率与应用场景决定,宏观层面的企业数量变化不会直接对其产生影响。此外,使用滞后一期的GitHub社区年度用户均值(Avg_users)作为用户需求的工具变量。这是因为GitHub社区用户量是用户需求的主要来源,平台层面由历史用户规模所形成的需求基础对单个项目的当期用户需求具有显著影响,但作为历史变量,其不会直接影响当前开源项目的创新绩效,因此满足工具变量的相关性和外生性条件。
表4为工具变量的回归结果。第一阶段结果显示,工具变量中国人工智能企业数(AIfirms)和开发者供给、滞后一期的社区年度用户均值(Avg_users)和用户需求都高度正相关,满足工具变量的相关性检验。第二阶段的回归结果显示,开发者供给和用户需求均在1%水平上显著为正,说明在控制内生性偏误后两类主体变量对开源项目创新绩效的正向影响依然存在。
表4 工具变量法结果
Table 4 Instrumental variable test results
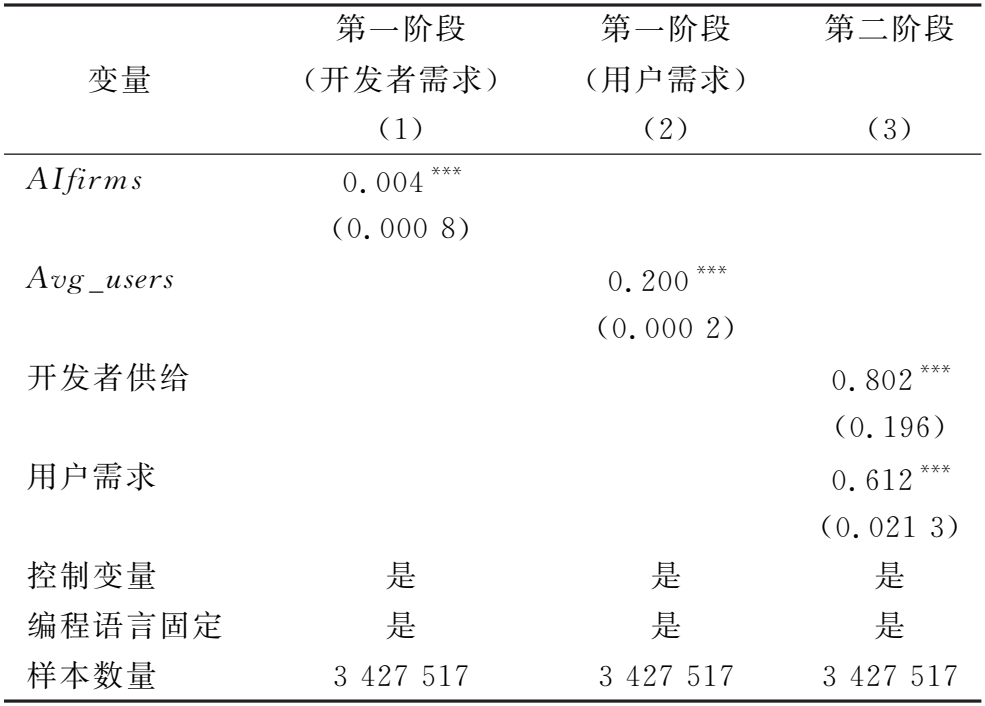
变量 第一阶段 (开发者需求) 第一阶段 (用户需求) 第二阶段 (1) (2) (3) AIfirms 0.004 *** (0.0008) Avg_users 0.200 *** (0.0002) 开发者供给 0.802 *** (0.196) 用户需求 0.612 *** (0.0213) 控制变量 是 是 是 编程语言固定 是 是 是 样本数量 3427517 3427517 3427517
鉴于人工智能领域开源项目的特殊性和重要性,进一步探讨不同技术领域的异质性效应,重点考察人工智能类开源项目的影响机制。
4.5.1 行业异质性
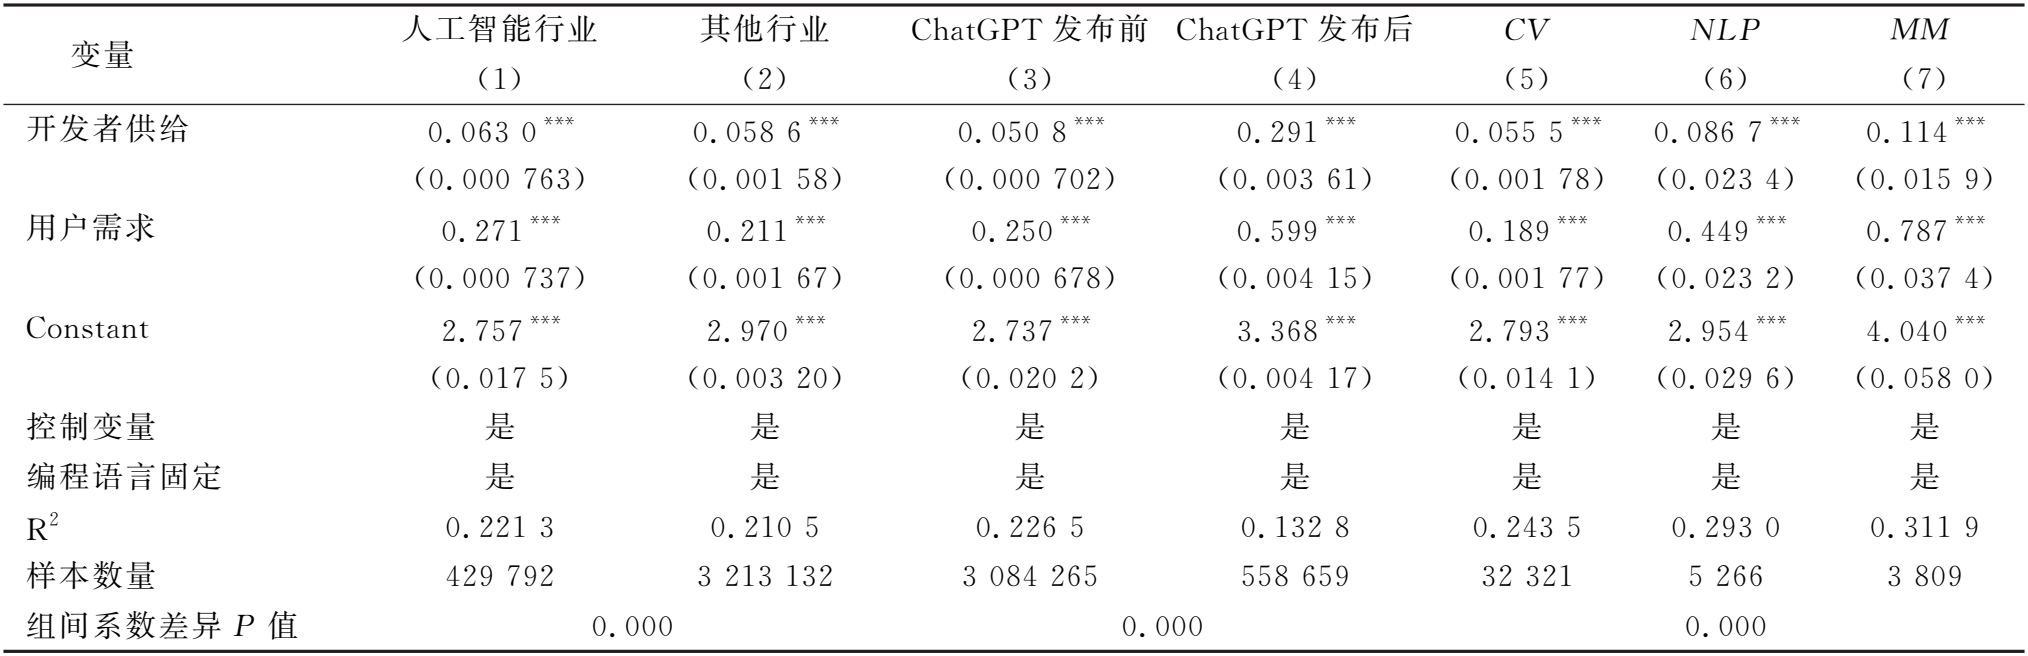
参考姚加权等[32]和王林辉等[33]的研究,并在此基础上加入对应的英文词作为筛选的关键词,构建包含80个人工智能关键词的识别词库,涵盖机器学习、深度学习、自然语言处理、计算机视觉等主要技术领域。当开源项目的topics包含这些关键词时,该项目被识别为人工智能行业项目。从表5可以看出,在人工智能行业中,用户需求对人工智能行业开源项目创新绩效的拉动作用更明显。这源于人工智能领域具有更高的技术门槛和知识密度,用户针对前沿技术的需求发挥显著的引导作用,驱动人工智能应用与发展[34-35]。
表5 异质性检验结果
Table 5 Heterogeneity test results
变量 人工智能行业 其他行业 ChatGPT发布前 ChatGPT发布后 CV NLP MM (1) (2) (3) (4) (5) (6) (7) 开发者供给 0.0630 *** 0.0586 *** 0.0508 *** 0.291 *** 0.0555 *** 0.0867 *** 0.114 *** (0.000763) (0.00158) (0.000702) (0.00361) (0.00178) (0.0234) (0.0159) 用户需求 0.271 *** 0.211 *** 0.250 *** 0.599 *** 0.189 *** 0.449 *** 0.787 *** (0.000737) (0.00167) (0.000678) (0.00415) (0.00177) (0.0232) (0.0374) Constant 2.757 *** 2.970 *** 2.737 *** 3.368 *** 2.793 *** 2.954 *** 4.040 *** (0.0175) (0.00320) (0.0202) (0.00417) (0.0141) (0.0296) (0.0580) 控制变量 是 是 是 是 是 是 是 编程语言固定 是 是 是 是 是 是 是 R 2 0.2213 0.2105 0.2265 0.1328 0.2435 0.2930 0.3119 样本数量 429792 3213132 3084265 558659 32321 5266 3809 组间系数差异P 值 0.000 0.000 0.000
注:组间系数差异P值根据交互项模型的Chow检验估计结果得到
进一步来看,相较于其他行业开源项目,人工智能开源项目中开发者供给对创新绩效的促进作用均更强,用户需求的影响更加突出。由于人工智能项目的应用前景广泛、社会关注度较高,其创新过程具有显著的数据驱动特征,用户在实际使用过程中所产生的数据反馈能够直接参与模型训练与性能优化,并通过持续的反馈循环反哺项目创新[36],形成“需求—数据—模型”的正向循环。因此,在人工智能行业中用户需求对开源项目创新绩效的拉动作用得到了显著提升。
4.5.2 时间异质性
自2022年11月30日OpenAI发布ChatGPT以来,大模型技术迅速引发全球范围的技术浪潮。与以往的技术迭代不同,ChatGPT不仅标志着生成式人工智能在自然语言处理上的突破,而且推动人工智能加速向通用目的技术(GPT, General Purpose Technology)演进。这推动开源社区对大模型相关项目的高度参与,尤其在人工智能领域,围绕大模型训练框架、推理优化与数据集管理的项目激增[37]。实证结果显示,ChatGPT发布前,开发者供给与用户需求均显著提升创新绩效,且用户需求作用大于开发者供给,表明需求拉动占主导;ChatGPT发布后,两者边际效应均显著增强。总体而言,ChatGPT的问世强化了需求拉动效应,同时,显著增大供给驱动机制的边际贡献。
4.5.3 人工智能细分子领域的异质性
参考Osborne等[4]的分类方法,将人工智能项目划分为计算机视觉(CV)、自然语言处理(NLP)和多模态(MM)三个技术子领域进行回归分析。结果显示,在三个子领域中,用户需求和开发者供给均表现出显著的正向作用,但作用强度存在明显差异。从表5的回归结果可以看出,自然语言处理与多模态项目对用户需求的敏感度更高,系数分别为0.449和0.787,远高于计算机视觉领域(0.189),表明用户需求在以语义处理和多模态交互为特征的数据驱动场景中更能转化为创新绩效[38]。
相较之下,开发者供给在三个子领域的作用差异较小,在多模态项目中作用更显著,说明在资源依赖度更高、架构更复杂的人工智能前沿项目中开发者贡献对创新绩效更重要。这一结果揭示了人工智能不同子领域的开源项目在需求拉动与供给驱动机制上的差异:自然语言处理和多模态领域的用户需求具有更突出的外溢效应与迭代反馈,且多模态领域开发者的技术投入对创新绩效的促进作用更突出。
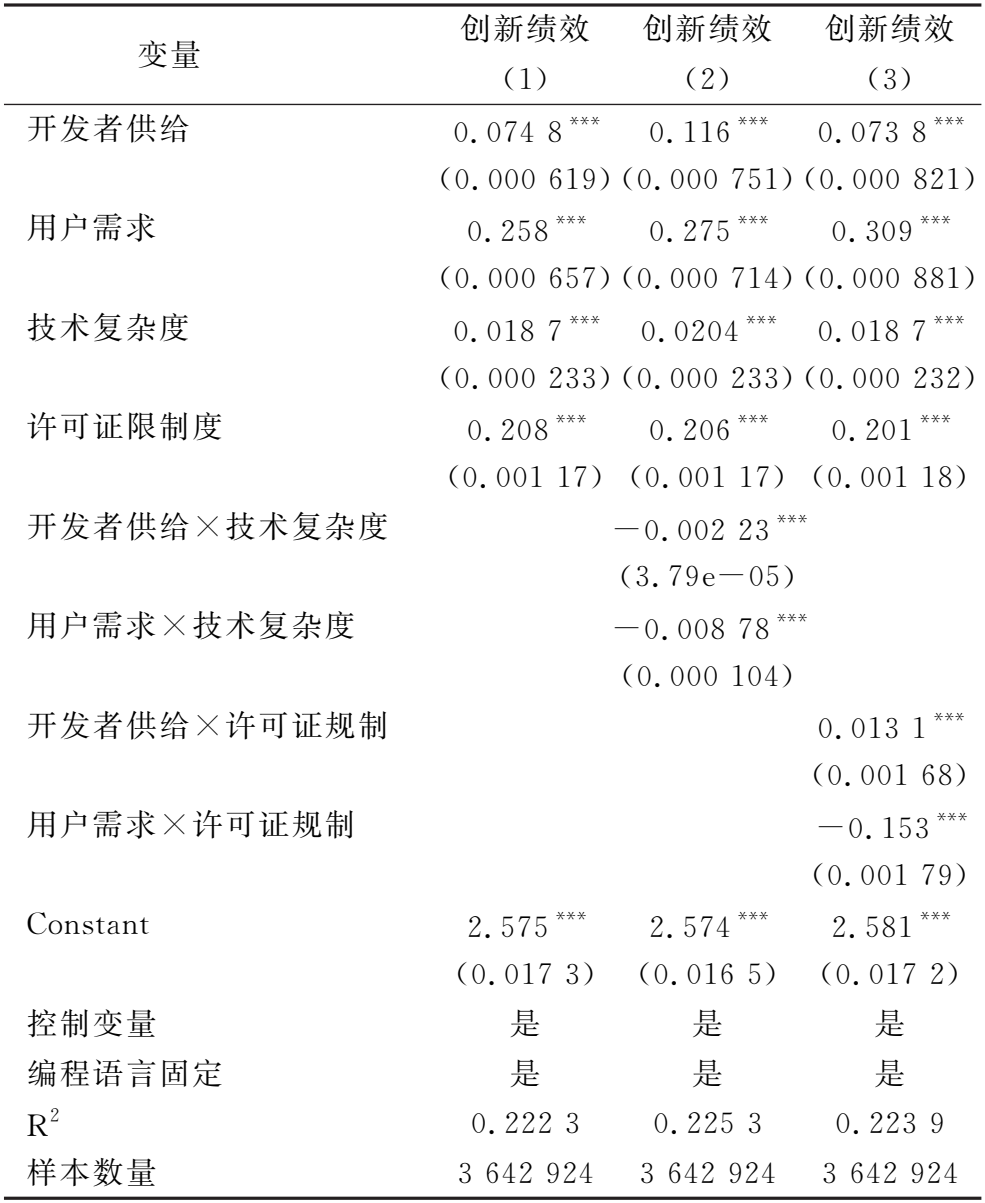
在完成主效应检验后,采用交互项估计揭示技术复杂度和许可证规制在用户需求拉动与供给激励过程中的调节效应,以清晰阐明调节机制对创新绩效的影响。技术复杂度抑制了开发者供给和用户需求对开源项目创新绩效的促进作用,而许可证规制能够有效增强开发者供给的促进作用,但削弱用户需求的促进作用。
4.6.1 技术复杂度的调节作用
表6列(2)显示,技术复杂度与用户需求、开发者供给的交互项均在1%水平上显著为负,表明技术复杂度越高,用户需求和开发者供给对开源项目创新绩效的正向影响越小,验证了“开放悖论”背景下复杂度会阻碍协同创新效应产生,即支持了假设H3a和H3b。因为随着技术模块化程度下降、接口依赖性上升,项目内生管理与协调成本显著提高,用户需求与开发者供给的边际贡献递减[37,39],从而削弱二者对开源项目创新绩效的正向推动作用。
表6 调节效应检验结果
Table 6 Test results of moderating effect
变量 创新绩效 创新绩效 创新绩效 (1) (2) (3) 开发者供给 0.0748 *** 0.116 *** 0.0738 *** (0.000619)(0.000751)(0.000821) 用户需求 0.258 *** 0.275 *** 0.309 *** (0.000657)(0.000714)(0.000881) 技术复杂度 0.0187 *** 0.0204 *** 0.0187 *** (0.000233)(0.000233)(0.000232) 许可证限制度 0.208 *** 0.206 *** 0.201 *** (0.00117) (0.00117) (0.00118) 开发者供给×技术复杂度 -0.00223 *** (3.79e-05) 用户需求×技术复杂度 -0.00878 *** (0.000104) 开发者供给×许可证规制 0.0131 *** (0.00168) 用户需求×许可证规制 -0.153 *** (0.00179) Constant 2.575 *** 2.574 *** 2.581 *** (0.0173) (0.0165) (0.0172) 控制变量 是 是 是 编程语言固定 是 是 是 R 2 0.2223 0.2253 0.2239 样本数量 3642924 3642924 3642924
4.6.2 许可证规制的调节作用
表6列(3)为许可证规制的调节作用检验,研究发现,开发者供给与许可证规制交互项系数显著为正,而用户需求与许可证规制交互项系数在1%水平上显著为负。这一发现符合产权激励的经典论断,即适度的排他权利有助于保护贡献者的再利用收益,从而激励其深度创新[39],支持了假设H4a;但对于普通用户而言,过于严格的许可限制会增加学习成本和抬高使用门槛,削弱其参与动力,证实了假设H4b成立。由此可见,严格的许可证通过强化知识产权保护机制增强对开发者的创新激励,但同时也抑制了用户的信息获取和需求拉动作用。
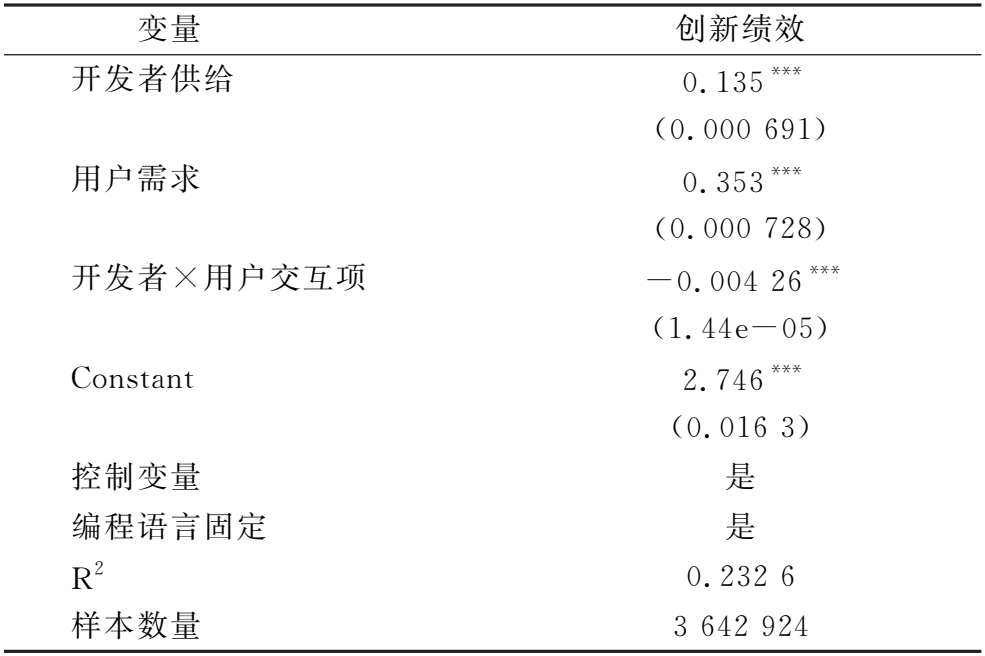
上述实证分析表明,用户需求与开发者供给会对开源项目创新绩效产生正向影响,然而用户与开发者是否孤立发挥作用?事实上,在开源社区这个协作平台上,用户作为市场需求方,开发者作为技术供给方,用户需求的多样性会直接影响开发者的创新方向与资源配置,而开发者的持续供给又会塑造用户的参与体验与后续需求偏好[40]。因此,为进一步揭示需求拉动与供给驱动在创新产出中的耦合逻辑,本文引入二者交互项,以检验二者共同对开源项目创新绩效的影响。
表7结果表明,用户需求与开发者供给的交互项系数显著为负,这意味着当用户需求和开发者供给同时处于较高水平时,他们对开源项目创新绩效的边际促进效应并非线性叠加,反而存在一定的拥挤效应[41]。这是因为,用户需求与开发者供给类似于市场需求与人才供给,二者处于较高水平时会引发资源配置障碍,这一发现也验证了开源项目中存在的“开放悖论”。具体而言,随着用户与开发者规模的同步扩张,信息沟通和知识整合成本显著上升,可能导致过度参与现象,使得开发者难以及时响应用户多元化、碎片化需求,从而降低创新效率。同时,高度活跃的用户群体在反馈与需求表达上可能出现异质化甚至冲突,迫使开发者在有限的资源与精力下进行取舍,进一步加剧协调难度。在人工智能开源项目中,模型迭代深度依赖算力和数据等稀缺资源[40],当用户提出大量需求而开发者资源有限时,过度需求反而可能挤出开发者在核心功能上的投入,形成需求过载风险。因此,负向交互效应的存在并不否定用户和开发者各自的正向作用,而是表明在双边规模均扩张的情境下创新绩效可能呈现边际递减,体现了开放式创新的复杂性与非线性特征。
表7 交互作用分析结果
Table 7 Interaction effect analysis
变量 创新绩效 开发者供给 0.135 *** (0.000691) 用户需求 0.353 *** (0.000728) 开发者×用户交互项 -0.00426 *** (1.44e-05) Constant 2.746 *** (0.0163) 控制变量 是 编程语言固定 是 R 2 0.2326 样本数量 3642924
本文基于GitHub平台近400万个开源项目的大样本数据,运用开放式创新理论系统分析开源项目创新绩效提升路径,得出以下主要结论:
(1)用户需求和开发者供给对开源项目创新绩效均产生显著正向影响,且用户需求的拉动作用大于开发者供给,即在人工智能开源项目中需求拉动机制具有更强主导性。这一发现不仅反映了人工智能时代用户需求所蕴含的潜在市场价值,而且揭示了人工智能时代开源创新所特有的数据驱动反馈循环机制。在人工智能项目中,用户需求往往通过真实应用场景转化为使用数据、测试样本和性能反馈[39],这些数据进一步参与模型训练与参数优化,推动项目技术性能持续提升,形成“需求—数据—模型”的正向循环[42]。这与传统创新理论中仅强调技术创新的观点形成对比,突出人工智能时代开源创新中市场导向和场景驱动的重要性。
(2)技术复杂度显著削弱用户需求和开发者供给对创新绩效的促进作用,体现了开源创新中的“开放悖论”。随着项目技术复杂度提升,参与门槛和协作成本提高,导致用户需求和开发者供给的边际贡献递减。这一结果表明,开放性并非能够无条件提升创新绩效,技术复杂性通过影响协作效率和参与结构,对开源创新的可持续性形成重要约束,从而揭示开放性与创新效率之间的内在张力。
(3)许可证规制对不同参与主体产生异质性影响——增强开发者供给的正向效应,但削弱用户需求的促进作用。一方面,严格的许可证规制通过保护开发者权益,激励其深度参与;另一方面,过度的规制约束可能抑制普通用户的参与积极性。这一发现表明,开源项目的治理机制在激励开发者深度参与的同时,也对需求侧参与形成抑制,反映了知识治理机制在开源创新中的双重效应。
(4)通过对开源项目的进一步分类发现,相比其他行业开源项目,人工智能开源项目中开发者供给与用户需求对创新绩效的促进作用均更为明显,但用户需求拉动作用的提升更加显著。从人工智能子领域来看,不同技术方向在需求拉动与供给驱动机制上表现出显著异质性:自然语言处理与多模态项目对用户需求的敏感度明显高于计算机视觉项目,而开发者供给在多模态领域的促进作用相对更强。这表明人工智能领域不仅具有较高的技术复杂度,还呈现出显著的数据驱动与场景驱动特征。尤其是在自然语言处理与多模态等高度依赖用户交互和数据反馈的领域,用户需求效应更易通过反馈循环被持续放大,从而在开源创新过程中发挥关键作用。
一是强化需求侧激励,完善以场景牵引的开源创新生态。鉴于用户需求的主导作用,应深入贯彻实施“人工智能+”专项行动,激发真实应用场景需求,增强需求端对开源创新的牵引作用。可在公共服务、智慧城市、医疗健康等领域优先采购和应用国产开源软件,提升优质开源项目的市场可见度与示范效应;设立专项补贴和创新券支持企业开源成果的产业化落地,防止开源创新成果长期停留在原型验证或实验室阶段。同时,鼓励行业协会和开源基金会举办开源大赛等活动,增强国产开源项目的社会影响力,促进国产开源项目走向世界。推动开源项目与产业应用深度融合,通过产学研合作提升开源创新的实用价值。
二是优化开源社区治理,缓解技术复杂度对协作创新的约束。考虑到技术复杂度的负向调节效应,推动开源社区在架构设计和治理模式上引入分层治理理念,通过技术架构优化降低参与门槛。政府和行业组织应加大支持开源项目的标准化建设,推动技术接口统一和文档标准化,减少因技术复杂性带来的协作成本增加。特别是在人工智能开源项目中,应加大公共算力与数据平台建设,缓解大模型训练与推理对算力资源的高度依赖,从而降低准入壁垒,提升开源社区整体的开放性与持续性。
三是完善制度环境,构建支持开源创新的系统性政策框架。针对当前企业贡献不足、社区自治弱、许可证合规意识低的现实,建议出台激励政策,引导龙头企业加大开源贡献力度,培育本土开源基金会和社区组织,推动开源创新纳入国家创新体系,在科技政策制定、创新资源配置、人才培养等方面给予专项支持。对于“国产开源项目出海难”,可在语言标准、国际认证、合规适配等方面提供公共服务,大力支持本土国际开源社区建设,帮助中国开源项目融入全球生态。
[1] 陈凯华,温馨,朱其罡.我国企业参与开源创新的现状、挑战与政策建议[J].中国科学院院刊,2025,40(3):477-482.
[2] 谢新水.智能跃迁、开源创新与主权AI:DeepSeek现象推动人工智能开源创新生态体系建设[J].电子政务,2025,22(3):40-48.
[3] 解学梅,郭潇涵.人工智能深度学习平台如何实现开源式创新[J].中国工业经济,2024,42(8):174-192.
[4] OSBORNE C, DING J, KIRK HR. The AI community building the future a quantitative analysis of development activity on Hugging Face Hub[J]. Journal of Computational Social Science,2024, 7(2): 67-105.
[5] AUGUST T, CHEN W, ZHU K. Competition among proprietary and open-source software firms:the role of licensing in strategic contribution[J]. Management Science, 2021, 67(5): 3041-3066.
[6] BENKLER Y.Coase's penguin, or, Linux and "the nature of the firm"[J]. Yale Law Journal, 2002,43(3): 369-446.
[7] 段玉聪.抢占AI话语权:DeepSeek的技术优势、战略布局与未来生态图景[J].新疆师范大学学报(哲学社会科学版),2025,46(4):109-125.
[8] 陈光沛,魏江,李拓宇.开源社区:研究脉络、知识框架和研究展望[J].外国经济与管理,2021,43(2):84-102.
[9] 焦豪,杨季枫.数字技术开源社区的治理机制:基于悖论视角的双案例研究[J].管理世界,2022,38(11):207-232.
[10] 温馨,梅亮,陈凯华,等.开源创新:理论内涵、知识框架与未来展望[J].科学学研究,2025,43(11):2300-2311.
[11] 李英姿,张丙雪,杨明萱.开源创新多重网络构建与分析:以百度Apollo为例[J]. 科研管理,2024,45(2):93-104.
[12] 李兰花,郭艳婷,钟宇琢.基于华为鸿蒙的开源社区多样化协作模式研究[J].科学学研究,2024,42(7):1461-1471.
[13] TANG T, FANG E, QUALLS WJ. More is not necessarily better: an absorptive capacity perspective on network effects in open source software development communities[J]. MIS Quarterly,2020, 44(4): 1651-1678.
[14] 郑晓龙,李家彤.人工智能时代的开源与闭源技术模式探讨[J]. 中国科学院院刊,2025,40(3):459-464.
[15] 陈晓红,周源.数智时代开源社区创新绩效的影响机制研究[J].科研管理,2025,46(6):136-145.
[16] 陈晓红,周源.基于合作与竞争视角下的开源软件创新合作本质和理论演进研究[J].科学学与科学技术管理,2024,45(12):13-30.
[17] 王京滨,刘赵宁,刘新民.数字化转型与企业全要素生产率——基于资源配置效率的机制检验[J].科技进步与对策,2024,41(3):23-33.
[18] 胡剑,戚湧.开源创新社区用户知识共享行为影响因素研究——基于SEM与fsQCA的实证分析[J].情报科学,2023,41(9):59-68,77.
[19] KORKMAZ G, CALDERON JB, KRAMER BL, et al. From GitHub to GDP: a framework for measuring open source software innovation[J]. Research Policy,2024, 53(3): 104-134.
[20] 郭海,李晓宇,黄冉.开放参与对开源软件项目绩效的影响研究——基于开放悖论视角[J].科学学与科学技术管理,2024,45(3):90-111.
[21] 贾开.人工智能应该开源吗?[J].文化纵横,2025,38(4):8-11,158.
[22] SMIRNOVA I, REITZIG M, ALEXY O. What makes the right OSS contributor tick treatments to motivate high-skilled developers[J]. Research Policy, 2022,51(1): 1-15.
[23] 邢青松,周宝嵘,邓富民.数字开源社区异质许可协议下贡献者策略演化及扩散研究[J].系统工程理论与实践,2024,44(8):2605-2625.
[24] 李杨,石梦茹,张佶,等.复杂系统视域下计算知识管理系统韧性治理框架[J].科技进步与对策,2025,42(18):150-160.
[25] BESSEN J, MASKIN E. Sequential innovation, patents, and imitation[J]. The Rand Journal of Economics,2009,40(4):611-635.
[26] 李兰花,陈真真,黄灿等.开源许可规制、技术复杂度与开源项目可持续发展:基于GitHub大样本实证研究[J/OL].科研管理,1-23[2025-12-17].https://link.cnki.net/urlid/11.1567.g3.20241209.1639.018.
[27] SHEORAN J,BLINCOE K,KALLIAMVAKOU E,et al.Understanding" watchers" on GitHub[C]. Proceedings of the 11th Working Conference on Mining Software Repositories,2014:336-339.
[28] 张慧颖,米学娇,曲霏.开放创新社区中用户人格特质如何影响其创意实施贡献——一个有调节的链式中介模型[J].科技进步与对策,2025,42(15):119-128.
[29] 陈光沛,魏江,李拓宇.基于社区的企业创新模式形成与演化:资源依赖的视角[J].研究与发展管理,2022,34(5):16-31.
[30] 吴欣,武健宇,周明辉,等.开源许可证的选择:挑战和影响因素[J].软件学报,2022,33(1):1-25.
[31] LERNER J, TIROLE J. Some simple economics of open source[J]. Journal of Industrial Economics, 2002, 50(2): 197-234.
[32] 姚加权,张锟澎,郭李鹏,等.人工智能如何提升企业生产效率?——基于劳动力技能结构调整的视角[J].管理世界,2024,40(2):101-116.
[33] 王林辉,胡晟明,董直庆.人工智能技术会诱致劳动收入不平等吗——模型推演与分类评估[J].中国工业经济,2020,38(4):97-115.
[34] 李晓华,宋孟起.开源的创新驱动作用及其治理机制[J].东北财经大学学报,2024,26(6):3-20.
[35] 尹西明,武沛琦,钱雅婷,等.先立后破:场景驱动如何助力AI新创企业实现最优区分?——基于微言科技的纵向单案例研究[J/OL].南开管理评论,1-31[2025-12-17].https://link.cnki.net/urlid/12.1288.F.20241210.0931.002.
[36] ERIC VH, GEORG VK. Open source software and the "private-collective" innovation model: issues for organization science[J]. Organization Science, 2003,14(2): 209-223.
[37] LAURSEN K, SALTER AJ. The paradox of openness: appropriability, external search and collaboration[J]. Research Policy, 2014, 43(5): 867-878.
[38] LINAKER J, RUNESON P. How to enable collaboration in open government data ecosystems:a public platform provider's perspective[J].Edem-ejournal of Edemocracy and Open Government,2021,27(1): 1-30.
[39] KENNETH A. Economic welfare and the allocation of resources for invention[M]//The rate of inventive activity:economic and social factors.Princeton:Princeton University Press,1962.
[40] 王哲,薛澜,赵静.开源创新组织的创新成本演化与动态治理机制[J].公共管理评论,2024,6(4):108-138.
[41] 宛群超,袁凌,谭志红.科技人才集聚、市场竞争及其交互作用对高技术产业创新绩效的影响[J].软科学,2021,35(11):7-12.
[42] 王学军,李航宇.公众参与合作生产的动机图谱及其影响——价值共创视角下的混合研究[J].公共行政评论,2023,16(2):4-24,196.