开放科学(资源服务)标识码(OSID):
Addressing this gap, this study exploits the staggered rollout of municipal public data openness platforms across Chinese cities as a quasi-natural experiment and employs a progressive difference-in-differences (DID) approach to analyze data from Chinese A-share listed companies (2008-2023) and examine the impact of public data openness on industrial chain linkage. The dependent variable, industrial chain linkage, is a composite proxy constructed as the product of two dimensions: (1) horizontal linkage, measured at the industry level by production segmentation length which captures the breadth and depth of inter-industry input dependencies and reflects cross-sectoral integration; and (2) vertical linkage, measured at the firm level by specialization degree, which reflects the intensity of upstream-downstream collaboration within the same industrial chain through deepened division of labor. The key explanatory variable is public data openness. In recent years, local government-led open data platforms have served as the primary vehicle for public data disclosure, and their phased implementation provides an ideal setting for empirical identification. Drawing on authoritative reports and academic literature, this study identifies 204 prefecture-level cities that have launched such platforms and manually collects each city′s platform launch year via comprehensive searches using Google, Baidu, and official government websites.
Key findings reveal that public data openness significantly promotes industrial chain linkage, with artificial intelligence applications acting as a critical moderating variable that accelerates this process. Mechanism tests confirm two core transmission channels: cost reduction and expectation stabilization. Heterogeneity analyses reveal that the positive impact of open public data on industrial chain linkages is more pronounced among private enterprises, competitive industries, high-tech industries, and companies in the growth and maturity stages. Further analyses demonstrate that public data openness enhances industrial chain resilience and security, stimulates cross-regional linkage effects, and advances coordinated regional economic development.
This study makes three potential contributions: First, it pioneers the analysis of public data openness as an enabler of industrial chain linkages, leveraging the exogenous shock of public data platform launches to expand relevant literature and offer practical insights for building advanced and efficient modern industrial systems. Second, it clarifies the multi-dimensional pathways (cost reduction, expectation stabilization, risk prevention) through which public data openness influences industrial chain linkages, while exploring heterogeneous effects across contexts, enriching research on industrial chain modernization. Third, by verifying the value-creation effects, resilience-enhancing role, and cross-regional linkage-promoting function of public data openness, the findings provide theoretical guidance for government departments to coordinate public data openness initiatives and for market entities to efficiently utilize public data. They also contribute to unlocking data dividends, advancing the integration of an efficient market and a proactive government, and supporting the security and modernization of industrial chains.
开放科学(资源服务)标识码(OSID):
党的二十届四中全会强调,提升产业链自主可控水平,促进区域创新链产业链高效协作。在数字产业化和产业数字化进程中,需要产业链上不同行业和企业间打破传统边界,实现跨企业协同增效和跨行业融合创新,构建全新产业生态[1]。当前,新一轮科技革命和产业变革正颠覆全球产业链分工格局和运行逻辑。贸易保护主义和地缘政治冲突使全球产业链呈现出“区域化”“本土化”布局趋势,同时,数智化转型加剧了产业链重构进程。基于此,科学评估我国产业链关联水平,破解“断链”风险,对于建设现代化产业体系具有重要意义。
从产业组织理论视角看,产业链关联的核心在于打破跨行业与跨企业的组织边界,数据作为一种新型生产要素,以其独有的渗透性、广泛性与易复制性正在重塑传统生产过程中的要素结构、网络组织与竞争格局[2]。作为全球最大的数据生产国,我国数据存储总量稳居世界前列,但“数据孤岛”等问题仍是横亘于我国数据总量攀升与数据利用效率提升之间的障碍。因此,打破数据壁垒、推动数据共享,是促进知识技术交流,提高产业链关联的核心要义。2024年9月,《中共中央办公厅 国务院办公厅关于加快公共数据资源开发利用的意见》明确提出“更好发挥市场机制作用,有效扩大公共数据供给,提高公共数据资源配置效率和使用效益”。我国地方政府自2012年开始逐步推进公共数据开放平台建设,平台数据涵盖政务管理、市场监管、工商经贸、信用评级、社保就业、科技创新等社会生产领域的基础性、关键性信息[3]。学界现有研究已证实公共数据开放在推动区域协调发展、促进人才聚集和技术协同[4]、提高企业创新与投资效率等方面的价值[5],但对“公共数据开放能否提升产业链关联”这一关键问题仍缺乏系统性讨论。鉴于此,本文将地级市公共数据平台陆续上线作为一项准自然实验,以2008—2023年沪深A股上市公司为研究样本,采用投入产出法和价值增值法测度产业链关联水平,同时使用多期双重差分模型考察公共数据开放对产业链关联的影响效应、作用机制与经济后果,为进一步释放公共数据价值,促进市场一体化建设,推动有效市场和有为政府相结合提供理论支持和决策参考。
本文边际贡献主要体现在三个方面:第一,考察公共数据开放对产业链关联的赋能作用。已有文献虽关注到公共数据开放在经济增长、协调发展等宏观经济层面[6]以及企业生产与投资效率等微观主体层面的价值[7],但鲜有涉及产业链关联这一主题。本文借助公共数据开放平台上线这一外生冲击系统评估公共数据开放对产业链关联的影响,丰富公共数据开放的经济效应研究,并为我国现代化产业体系建设提供经验证据。第二,证实公共数据开放影响产业链关联的作用渠道。相关研究虽间接考量了公共数据开放在产业链关联方面的潜力,但未进一步考虑政府数据所承载的信息价值以及数据本身所具有的关联特性。因此,本文系统探究公共数据开放影响产业链关联的传导路径,并在此基础上进一步考察其在不同情境下的异质性特征,拓展研究边界。第三,研究结论具有重要的现实意义。本文基于产业链关联视角,验证公共数据开放的价值创造效应,同时围绕“打造自主可控的产业链”这一目标,深入剖析其对产业链韧性、安全水平以及产业跨区域协同的影响。研究结论可为政府部门科学统筹公共数据开放工作、市场主体规范高效利用公共数据提供理论支持,同时为加快释放数据要素红利、推动有效市场与有为政府协同建设提供政策启示。
自亚当·斯密提出劳动分工理论以来,经济活动中自然演化的专业化分工行为就形成了彼此间相互嵌套的协作生产网络。目前学界关于产业链关联的研究主要围绕两方面展开:一是技术关联论,认为产业链关联是基于一定技术经济关联所形成的链条式关系形态,技术创新在产业链形成与发展中占据主导作用,不同产业之间的技术延续性和依赖性是形成产业链关联的关键[8]。技术的生成、发展及其外部效应持续改变着产业间的关联方式,并呈现出阶段性特征,应通过促进企业关键技术升级、推动数字化转型等提高产业链关联水平[9]。二是生产关联论,关注生产流程中的投入产出关系,即一种产品的生产对另一种产业的原材料、半成品或服务的依赖性,这种依赖性形成了产业间的紧密联系,影响着产业集群的竞争优势和可持续发展,并提出产业融合[10]、结构性降税[11]等具体措施。
公共数据开放有助于破解企业面临的数据“可用不可见”激励困境,同时为企业提供更多获取信息和嵌入生产合作网络的机会。对此,有学者从规模效应、创新效应和邻近效应三个维度对其进行阐释。规模效应指数据要素有不同于传统生产要素边际报酬递减的特质,具有非竞争性和正外部性特征[12],能促进区域层面的经济高质量发展与要素优化配置,使数据要素更好融入企业生产体系,降低企业不确定性感知,提高生产效率[13]。创新效应指数据要素流动能够重构企业知识配置结构,通过催生新的商业需求场景、提供丰富的数据要素供给、推动企业数字化转型等方式,驱动企业创新范式变革[14],并以此帮助企业更新业务和管理模式。邻近效应指公共数据开放能打破信息壁垒,有效聚集资金、技术、人才等生产要素,形成产业协同集聚、要素配置优化的良性循环[15],构建优质的营商环境[16],放大整体社会经济价值。还有学者指出,我国公共数据开放虽已达到使用机会平等,但企业间数字转化应用的鸿沟仍然存在,公共数据确权困难、交易制度供给不足等问题仍旧突出[17]。
综上,以往文献虽间接分析了公共数据开放在推动产业发展集聚、促进专业化协作等方面的作用,为本研究提供了有益的理论支撑,但聚焦宏观经济价值层面抑或企业生产等微观视角,难以解释公共数据开放的产业链关联效应及运行机理。鉴于此,本文旨在系统深入刻画数据开放对产业链关联的影响机制,进一步揭示公共数据开放的深层价值。
信息不对称引发的链上主体协作不畅是传统产业链关联中的核心制约因素。公共数据作为政府履职过程中产生的标准化、高可信度的数据资源,涵盖政策环境、市场动态等关键信息,其开放可直接作用于产业链关联的核心环节。首先,公共数据开放可以打破产业链信息壁垒[18],促进信息协同。通过平台化整合和标准化供给,可以实现政务数据的集中整合与实时更新,让产业链各环节企业通过统一入口获取一致信息。其次,公共数据开放能够提高产业链资源匹配效率,拓宽关联范围。产业链从局部联动走向更广泛的协作,关键在于链上企业精准找到合适的合作伙伴和资源。政府开放的市场需求监测数据、公共资源布局数据等,能够帮助企业快速识别业务拓展区域的潜在关联主体,拓宽企业协作范围。最后,公共数据开放能够助力产业链技术协同,提升关联质量。公共数据开放提供的技术标准、科研资源等数据,能够为企业技术协作提供规范化的制度框架,技术创新成果转化数据则有助于跨行业的技术融合,有效提升产业链关联的技术含量和附加值。因此,本文提出如下假设:
H1:公共数据开放能够增强产业链关联。
公共数据开放是一项兼具政府协同治理、市场经济运行与公共价值创造的重要议题,考虑到公共数据资源的信息价值与公共品属性[19],本文从降成本、稳预期、防风险三个方面探讨其作用机制。
2.2.1 降成本效应:降低制度性交易成本
在产业链关联中,制度性交易成本的形成与政府治理环节的信息壁垒密切相关,企业需耗费大量成本适配政策差异、对接多部门审批流程、搜寻分散的公共服务信息。公共数据开放有助于降低此类成本。其一,推动跨区域政策信息协同,可降低政策适配成本。地方政府开放产业准入、环保标准、税收优惠等公共数据,可帮助企业清晰把握区域政策衔接要点,无需反复研究多地规则差异。其二,优化行政审批流程,可降低行政沟通成本。依托一体化公共数据平台,产业链协作所需的资质核验、项目备案等流程可实现线上通办。其三,提升公共服务信息获取效率,可降低信息搜寻成本[20]。企业通过平台可便捷查询政府规划、资源布局、监管动态等信息,减少因信息分散导致的查询耗时。制度性交易成本的降低,不仅可降低企业准入门槛,更可促使企业积极拓展主营业务,更好地融入市场并参与产业链分工,从而增强产业链关联。由此,本文提出如下假设:
H2a:公共数据开放通过降低制度性交易成本增强产业链关联。
2.2.2 稳预期效应:降低不确定性感知
链上企业对未来市场环境、技术发展趋势等方面的不确定性感知会降低其协同能力和效率,使其回避技术共享。而公共数据开放能够为企业提供高可信度、动态更新的市场信息,可降低其不确定性感知。一方面,公共数据开放整合宏观与行业动态数据,可降低市场供需预测不确定性。政府开放的消费趋势、行业产能、进出口贸易等数据,能够帮助企业全面把握市场供需变化。另一方面,公共数据开放细化政策执行信息,可降低政策理解不确定性。政府通过平台公开产业支持政策的申报指引、审核进度、资金拨付等内容,帮助企业清晰把握政策执行节奏,避免因理解偏差调整协作布局。基于此,可以推断,在稳预期效应下,企业将恢复长期投资信心,产生创造新的竞争优势和长期投资回报的内生动力,进而开展并购活动和产业投资,拓展主营业务。这一过程客观上促进了专业化分工协作,加强了产业链关联。由此,本文提出如下假设:
H2b:公共数据开放通过降低不确定性感知增强产业链关联。
2.2.3 防风险效应:防范企业寻租行为
企业寻租会破坏市场竞争,阻碍产业链协作以维持垄断地位。公共数据开放通过打破政企信息壁垒、强化监管与社会监督,减少此类非生产性行为。首先,公共数据开放推动政府资源配置信息透明,可减少非生产性资源获取空间。政府将土地出让、项目招标、财政补贴发放等数据按规范公开,使资源分配过程清晰可查。其次,公共数据开放促进政府部门间数据协同,可提升非合规行为识别效率。例如,税务、市场监管等部门通过公共数据平台,可实时核验企业经营信息与申报内容,及时发现并切断可能的寻租路径。最后,公共数据开放强化社会监督,可降低非生产性行为的收益预期。政府合作记录等数据通过平台公开,形成行业与社会层面的监督氛围,使非生产性行为面临更高社会压力和寻租风险感知,进而引导企业转向合规竞争。在防风险效应下,产业链的竞争重心逐步向技术创新与协作效率转移,企业需通过提升产品质量、优化协作流程获取市场地位,倒逼企业强化产业链专业化分工和上下游联合研发,提升合作需求与意愿,产业链关联随之提升。由此,本文提出如下假设:
H2c:公共数据开放通过防范企业寻租行为增强产业链关联。
以互联网、云计算、大数据、人工智能等为代表的新一代智能技术深入应用推动了企业由数字化向数智化迈进,企业间技术关联及空间布局正发生着深刻变革。在这一过程中,一方面,公共数据开放因其普惠性,打破了传统生产要素高门槛造成的垄断问题,客观上促进了人工智能应用;另一方面,借助人工智能等前沿技术,企业能进一步释放海量公共数据价值。由于当前国际经济与贸易环境的不确定性,企业面临较高的融资成本和风险水平,人工智能应用显著优于其他投资行为的特点是能够借助智能技术构建自动化运营和智能化决策体系,从而长期持续抵御市场风险。近年来我国各级政府连续出台政策文件和配套保障措施,鼓励行业龙头企业、互联网平台企业开放数据,推动跨企业、跨行业数据可信交互和整合利用。公共数据开放结合智能技术应用能极大提高信息获取和传递效率,有利于营造公平竞争的营商环境,降低企业拓展业务边界的成本。与此同时,平台上线和数据更新等过程会依据市场动态进行调适,体现出有效市场对有为政府的反馈。由此,本文提出如下假设:
H3:在公共数据开放赋能产业链关联的过程中,人工智能应用起正向调节作用。
由于公共数据开放平台分批次上线,各地级市的上线时间存在差异,本文可利用渐进双重差分法识别公共数据开放与产业链关联之间的因果效应,构建基准回归模型如下:
Linkit=α0+α1Datact+λControlict+μn+δi+βt+εnit
(1)
其中,Linkit表示i公司在t年的产业链关联水平;Datact表示公共数据开放这一政策冲击变量,相当于传统双重差分模型的交互项,包含地区c和时间t两个维度;Controlict为控制变量,μn、δi和βt分别为行业、企业和年份固定效应,εnit为随机误差项。对模型(1)进行检验,若α1显著为正,说明公共数据开放能够增强产业链关联。
3.2.1 被解释变量
产业链关联(Link)。本文对其的界定是,通过跨企业、跨行业的资源整合和协同创新,实现企业间专业化分工合作及行业间优势互补的动态过程,本质是通过打破传统产业边界,构建行业、企业间分工合作的关联生态。借鉴张虎等[21]的研究,从横向关联和纵向关联两个层面进行表征:
(1)横向关联是指不同产业链或不同行业间的合作,使用投入产出法测度。借鉴Zheng等[22]的研究,采用矩阵转换法得到2008—2023年的投入产出表,并基于此对生产分割长度进行测算。生产分割长度越长,表明生产一单位该产品需要其他行业产品的支撑越多,产业链关联水平越高。计算公式为:
Psln=1+∑εmnPslm
(2)
其中,Psl表示行业n的生产阶段数,ε表示生产一单位行业n产品需要投入的行业m产品数量。如果生产过程不需要中间投入,则生产阶段数为1。
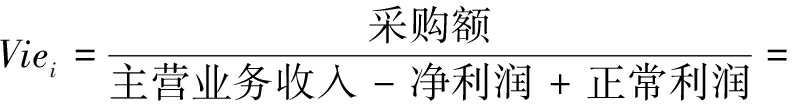
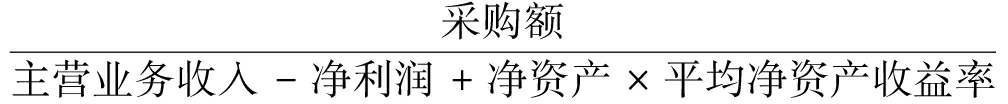
(2)纵向关联指同一产业链上下游企业间的合作,参考范子英和彭飞[23]的测算方式,使用价值增值法测度,以反映企业专业化分工程度。企业专业化分工程度越高,产业链关联水平越高,计算公式如下:
(3)
其中,Vie表示企业i的专业化分工程度,正常利润使用企业净资产与行业净资产收益率的乘积表示。
由于产业链以投入产出为纽带,联结行业与企业两个层面,因此本文将上述两项指标的乘积作为产业链关联的代理变量,以更全面捕捉上下游行业及大中小企业间的关联关系,即行业n中企业i的产业链关联水平(Link)表示为:
Linki=Psln×Viei
(4)
3.2.2 核心解释变量
公共数据开放(Data)。地级市作为区域经济发展与产业链协同的核心枢纽,其公共数据开放平台更贴近产业链上下游企业的实际数据需求,相关平台的陆续上线也为公共数据开放识别提供了理想的准自然实验场景。本文通过查阅相关文献和研究报告确定截至2023年共有204个地级市公共数据开放平台上线,并进一步借助谷歌、百度等搜索引擎手动检索各地级市公共数据平台的上线年份。对于这一政策冲击,采用虚拟变量进行定义,若企业所在地区当年上线了地级市公共数据开放平台,Data赋值为1,否则为0。
3.2.3 中介变量
(1)制度性交易成本(Tra)。本文构建三个指标以刻画企业的制度性交易成本:参考何雨可等[24]的研究,采用上市公司的销售费用、管理费用、财务费用之和占总资产的比重表征制度性交易成本。借鉴倪骁然和张宸瑞[25]的做法,补充两个代理变量。一是产业链上游话语权(Dup),测度方式为(应付账款+应付票据—预付账款)/总资产;二是产业链下游话语权(Ddown),测度方式为(应收账款+应收票据—预收账款)/总资产。
(2)不确定性感知(Unc)。 借鉴聂辉华等[26]的做法,首先,通过Python爬虫功能提取上市公司年报中“管理层讨论与分析”模块作为政策分析文本,采用文本分析的方法构造“不确定性词语库”。然后,构建两个指标用于测度企业面临的不确定性感知:①不确定性感知程度(Unpro),以不确定性词语数量占“管理层讨论与分析”模块总词语数量的比重测度;②不确定性感知增长率(Urate),以不确定性词语的增长率测度。
(3)寻租行为(Ren)。 本文采用寻租程度[27]、寻租倾向[28]表征寻租行为:①寻租程度(Exp),采用管理费用中业务招待费与企业总资产之比表示;②寻租倾向(Exc),以超额管理费用刻画,若超额管理费用大于0,寻租行为赋值为1,反之则赋值为0。具体测度方式如下:
Manit=β0+β1lnSaleit+β2Levit+β3Growit+β4Nbdit+β5Staffit+β6Sait+β7Ageit+β8Maginit+β9T5it+λControlit+δn+δi+δt+εnit
(5)
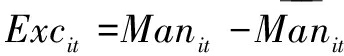
(6)
其中,Excit表示超额管理费用,Manit表示企业实际管理费用, 表示期望管理费用;lnSaleit为营业收入的自然对数,Levit为资产负债率,Growit为营业收入增长率,Nbdit为董事会规模,Staffit为员工数量,Sait为审计质量,若该公司审计单位为四大会计师事务所,则Sa=1,否则为0,Ageit为上市年限,Maginit为净利率,T5it为股份集中度,用上市公司前五大股东持股比例表示。
3.2.4 调节变量
人工智能技术应用(Int)。借鉴王娇等[29]的测度方式,采用企业人工智能专利申请量作为该变量的代理变量,依据《战略性新兴产业分类与国际专利分类参照关系表(2021)》,检索并汇总各地区关于深度学习、计算机视觉、云计算、语音识别、智能机器人、智能驾驶和自然语言处理等7类典型的人工智能专利申请数量,以此衡量企业的人工智能技术创新活跃度。
3.2.5 控制变量
考虑到企业微观特征与城市宏观环境均会影响产业链关联,参考已有文献[30],本文从企业、城市两个层面选取控制变量。企业层面控制变量包括:企业规模(Lnsize),取企业总资产的对数;资产负债率(Leverage),取企业总负债与总资产的比值;资产收益率(Roa),取企业净利润与总资产的比值;净资产收益率(Roe),取企业净利润与股东权益的比值;企业年龄(Age),取企业成立的年数;市值账面比(Bm),取企业市值与账面价值的比值;产权性质(State),若企业为国企则取值为1,为非国企则取值为0;管理层持股比例(Mss),取高管持股比例表示。城市层面控制变量包括:经济发展水平(Rgdp),取人均GDP自然对数;对外开放程度(Open),取进出口总额与GDP的比值;产业结构(Str),取第三产业生产总值占第二产业生产总值的比重表示。
选取2008—2023年沪深A股上市公司为研究样本,并对初始数据进行如下处理:剔除金融行业样本;剔除ST、PT以及资不抵债的样本;剔除主要变量数据缺失的样本,最终得到上市公司的公司—年度观测值。本文使用的数据主要分为三类:①公共数据开放平台上线时间数据,主要来源于国家信息中心和复旦大学发布的《中国地方政府数据开放报告》、华中师范大学发布的《中国政府开放数据利用研究报告》。②公司层面数据,主要来源于国泰安数据库、万得数据库和巨潮资讯网的企业年报。③城市层面数据,主要来源于历年《中国城市统计年鉴》。
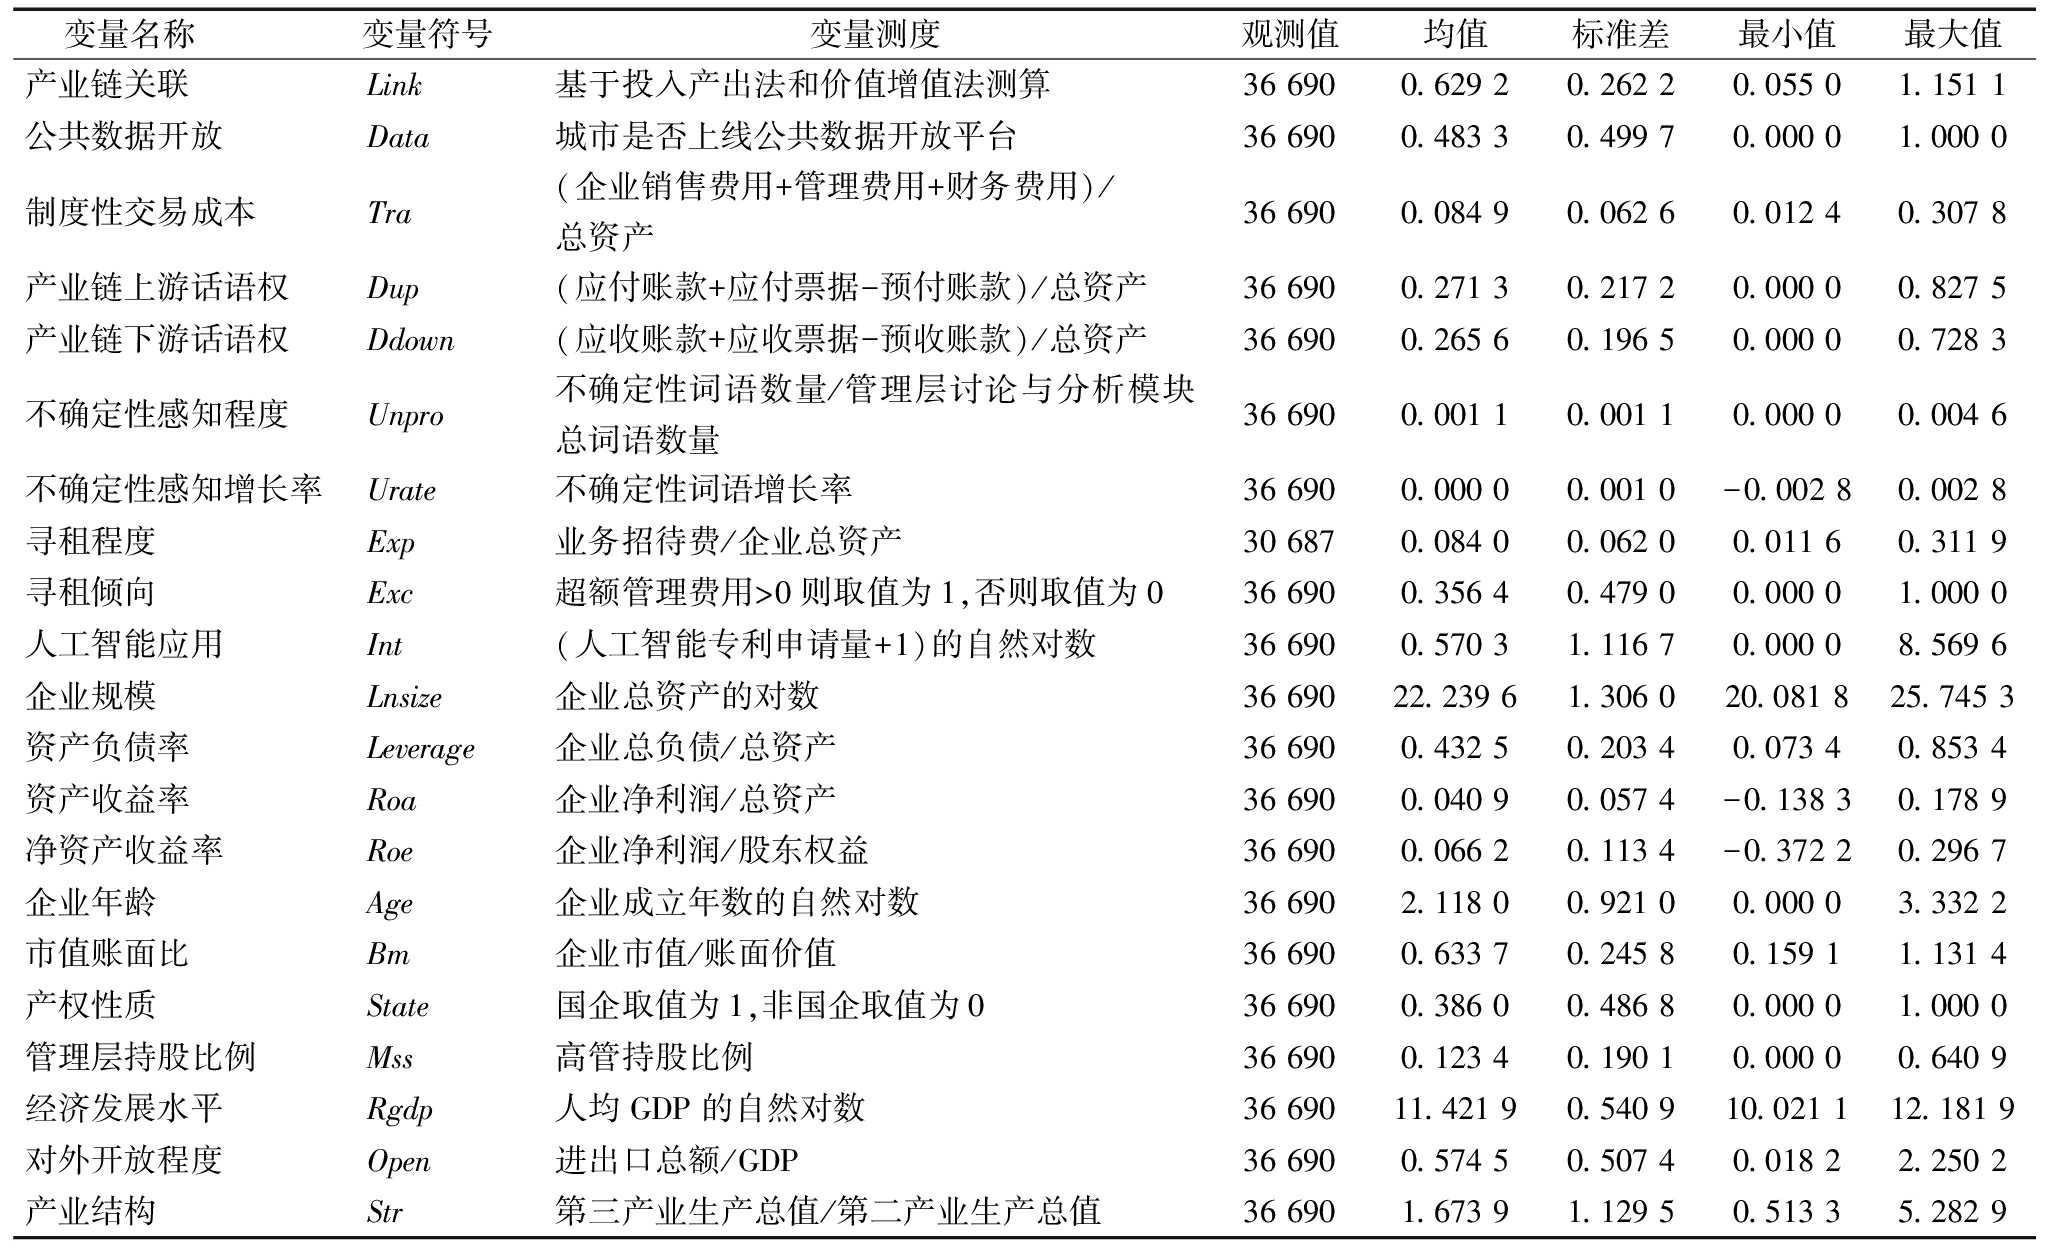
变量描述性统计结果如表1所示,被解释变量产业链关联的均值、标准差、最小值和最大值分别为0.629 2、0.262 2、0.055 0和1.151 1,最大值为最小值的20.9倍,说明样本中不同行业企业的产业链关联水平分化明显。核心解释变量公共数据开放的均值为0.483 3,表明样本调查期内有48.33%的企业所在城市上线了公共数据开放平台。
表1 变量说明及描述性统计结果
Table 1 Variable description and descriptive statistical results
变量名称 变量符号 变量测度观测值均值标准差最小值最大值产业链关联Link基于投入产出法和价值增值法测算36 6900.629 20.262 20.055 01.151 1公共数据开放Data城市是否上线公共数据开放平台36 6900.483 30.499 70.000 01.000 0制度性交易成本Tra(企业销售费用+管理费用+财务费用)/总资产36 6900.084 90.062 60.012 40.307 8产业链上游话语权Dup(应付账款+应付票据-预付账款)/总资产36 6900.271 30.217 20.000 00.827 5产业链下游话语权Ddown(应收账款+应收票据-预收账款)/总资产36 6900.265 60.196 50.000 00.728 3不确定性感知程度Unpro不确定性词语数量/管理层讨论与分析模块总词语数量36 6900.001 10.001 10.000 00.004 6不确定性感知增长率Urate不确定性词语增长率36 6900.000 00.001 0-0.002 80.002 8寻租程度Exp业务招待费/企业总资产30 6870.084 00.062 00.011 60.311 9寻租倾向Exc超额管理费用>0则取值为1,否则取值为036 6900.356 40.479 00.000 01.000 0人工智能应用Int(人工智能专利申请量+1)的自然对数36 6900.570 31.116 70.000 08.569 6企业规模Lnsize企业总资产的对数36 69022.239 61.306 020.081 825.745 3资产负债率Leverage企业总负债/总资产36 6900.432 50.203 40.073 40.853 4资产收益率Roa企业净利润/总资产36 6900.040 90.057 4-0.138 30.178 9净资产收益率Roe企业净利润/股东权益36 6900.066 20.113 4 -0.372 20.296 7企业年龄Age企业成立年数的自然对数36 6902.118 00.921 00.000 03.332 2市值账面比Bm企业市值/账面价值36 6900.633 70.245 80.159 11.131 4产权性质State国企取值为1,非国企取值为036 6900.386 00.486 80.000 01.000 0管理层持股比例Mss高管持股比例36 6900.123 40.190 10.000 00.640 9经济发展水平Rgdp人均GDP的自然对数36 69011.421 90.540 910.021 112.181 9对外开放程度Open进出口总额/GDP36 6900.574 50.507 40.018 22.250 2产业结构Str第三产业生产总值/第二产业生产总值36 6901.673 91.129 50.513 35.282 9
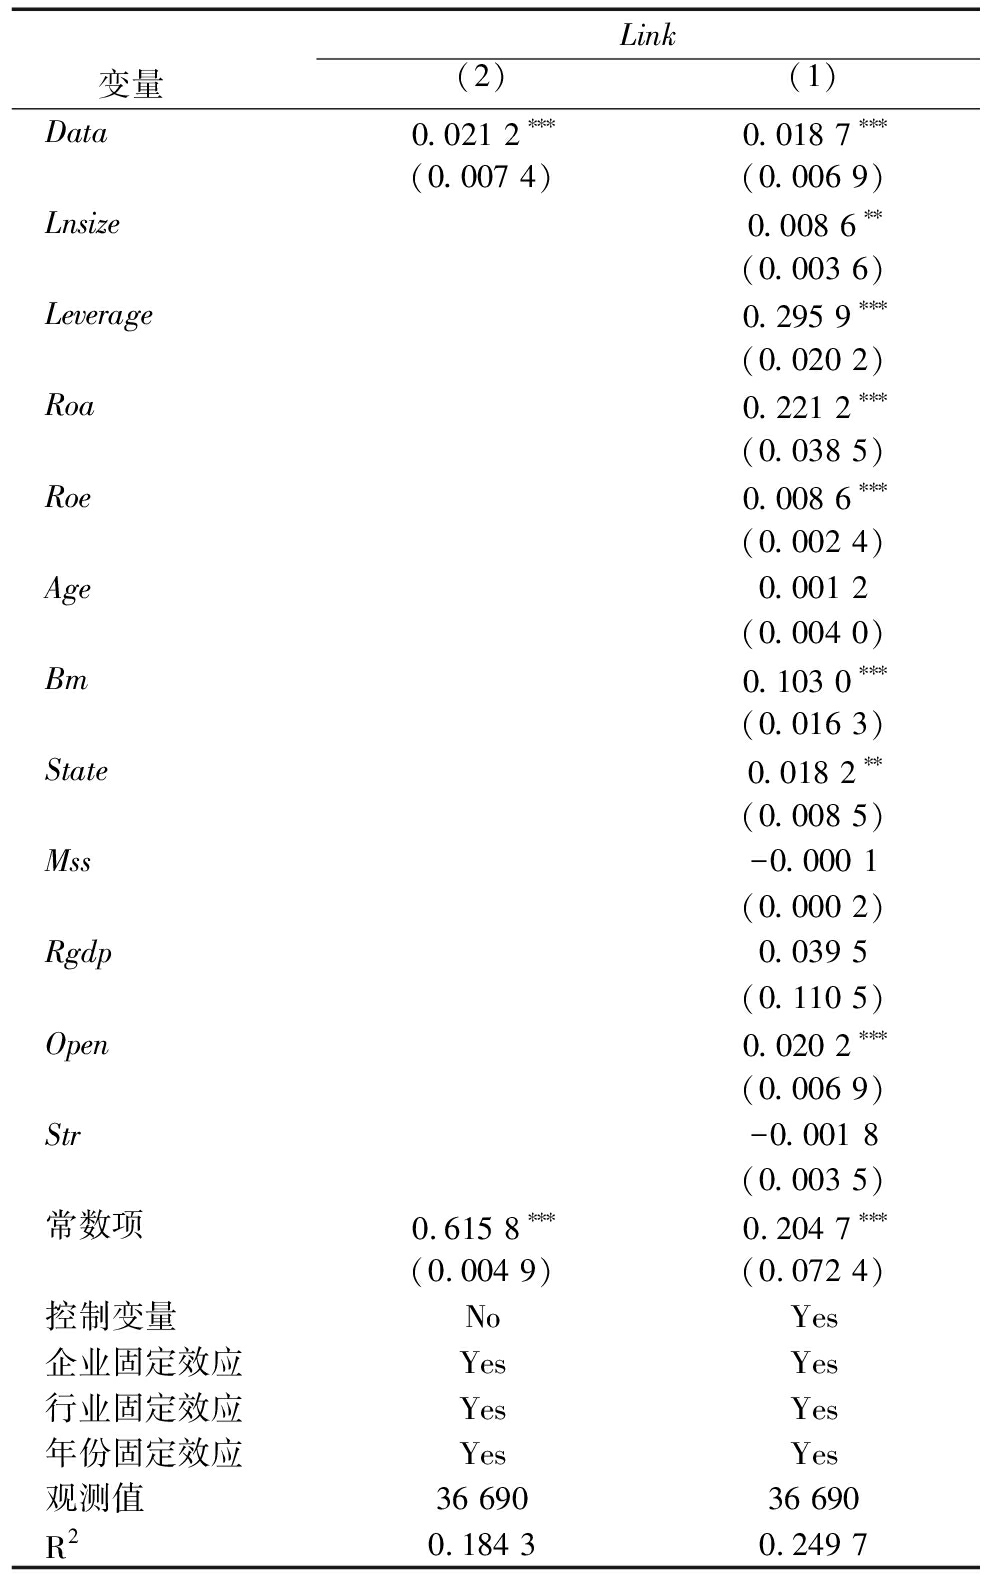
表2报告了“公共数据开放与产业链关联”二者关系的基准回归结果。其中,列(1)结果显示在仅控制固定效应的情况下公共数据开放的回归系数在1%的显著性水平上为正,初步表明公共数据开放能够显著促进产业链关联。基准回归模型中加入控制变量,列(2)结果显示基准回归系数的符号和显著性水平并未改变,说明在控制其他影响因素后,公共数据开放依然能够构建互联互通、高效协作的行业和企业间关系,显著促进产业链关联水平提升,假设H1得以验证。
表2 基准回归结果
Table 2 Beseline regression results
变量 Link(1)(2)Data0.021 2∗∗∗0.018 7∗∗∗(0.007 4)(0.006 9)Lnsize0.008 6∗∗(0.003 6)Leverage0.295 9∗∗∗(0.020 2)Roa0.221 2∗∗∗(0.038 5)Roe0.008 6∗∗∗(0.002 4)Age0.001 2(0.004 0)Bm0.103 0∗∗∗(0.016 3)State0.018 2∗∗(0.008 5)Mss-0.000 1(0.000 2)Rgdp0.039 5(0.110 5)Open0.020 2∗∗∗(0.006 9)Str-0.001 8(0.003 5)常数项0.615 8∗∗∗0.204 7∗∗∗(0.004 9)(0.072 4)控制变量NoYes企业固定效应YesYes行业固定效应YesYes年份固定效应YesYes观测值36 69036 690R20.184 30.249 7
注:*、**、***分别表示10%、5%、1%水平上显著,括号内为聚类到企业层面的稳健标准误,下同
4.2.1 平行趋势检验
为验证本研究事前平行趋势假定是否成立,本文采用事件研究法对地级市公共数据开放平台上线的产业链关联效应进行考察。具体模型如下:
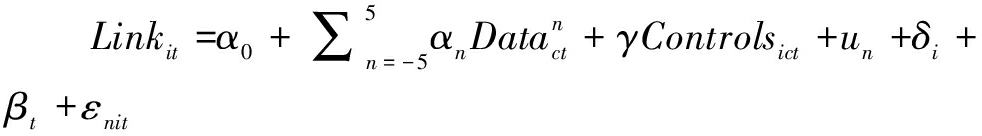
(7)
其中,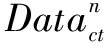 是以公共数据开放平台上线当年作为参照的政策时间的相对年份虚拟变量,以地级市公共数据平台的上线年份赋值,为保证政策相对时间的平衡性,本文选取了政策前后5期作为时间窗口,并以政策前一年为基期进行事前趋势检验。检验结果如图1所示,在政策发生前,核心解释变量的影响系数并不显著异于0,表明对照组与处理组并不存在明显差异,检验结果与平行趋势假设一致。
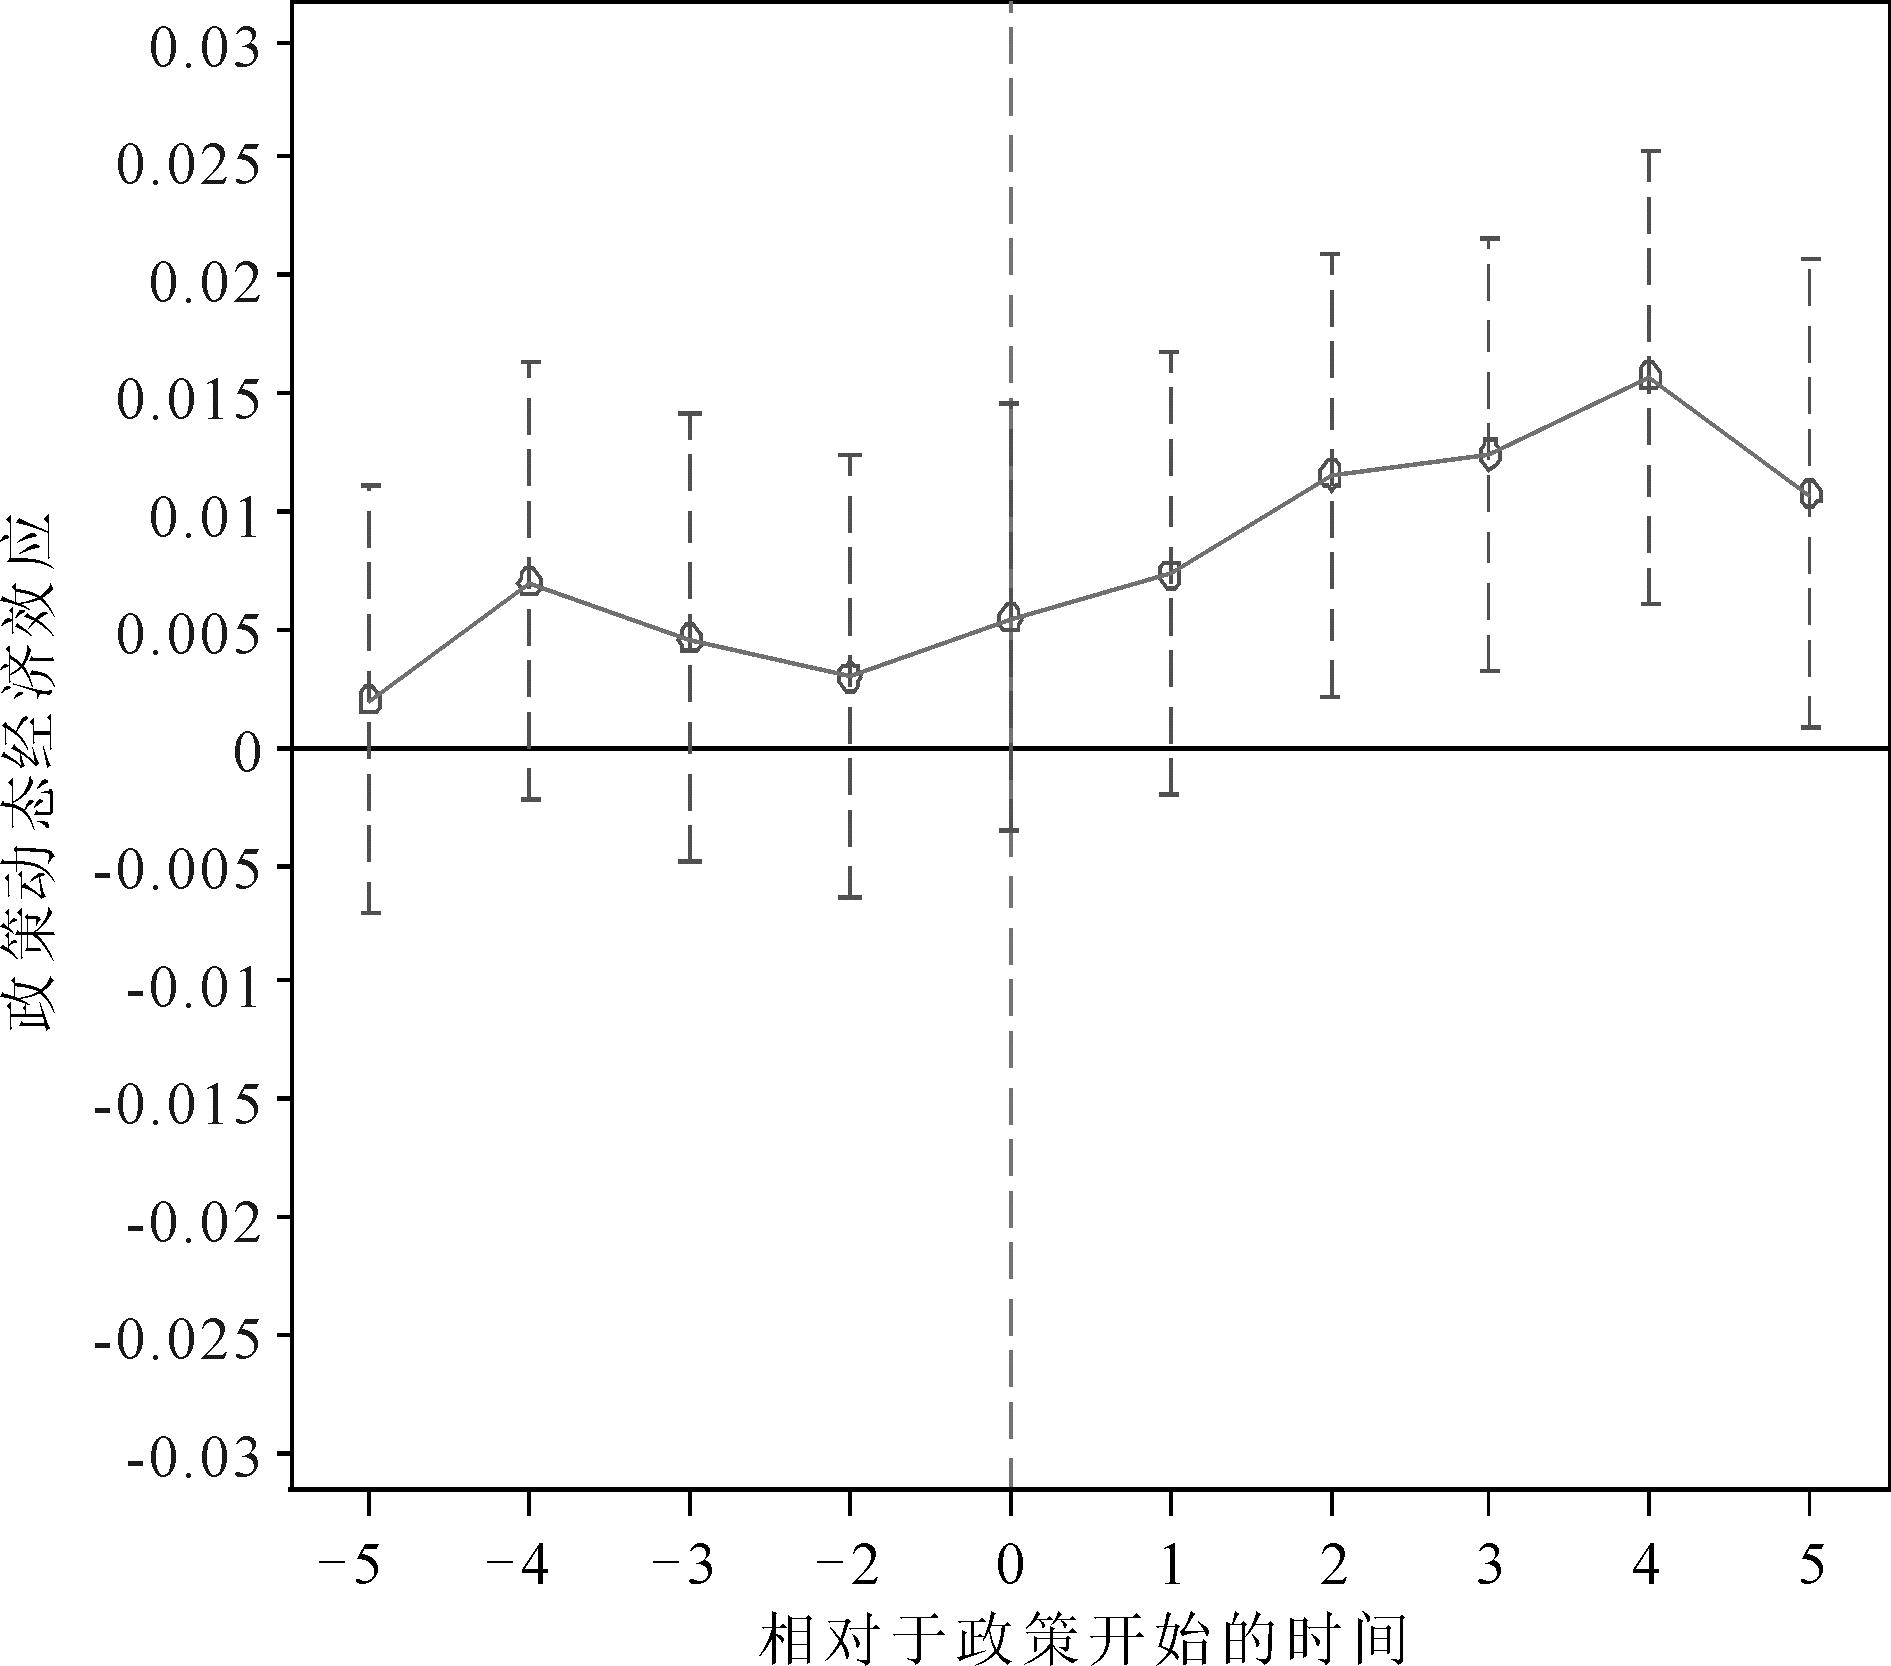
图1 平行趋势检验结果
Fig.1 Parallel trend test results
4.2.2 安慰剂检验
为排除可能存在的其他随机因素对研究结果的影响,进一步进行安慰剂检验。通过随机设定公共数据开放平台的上线城市与年份,重复随机抽样500次后基于基准模型回归进行安慰剂检验。图2展示了公共数据开放的估计系数及p值分布的核密度趋势分布,绝大部分估计系数均小于基准回归系数0.018 7,且显著性水平大于10%,进一步验证了结论的稳健性。
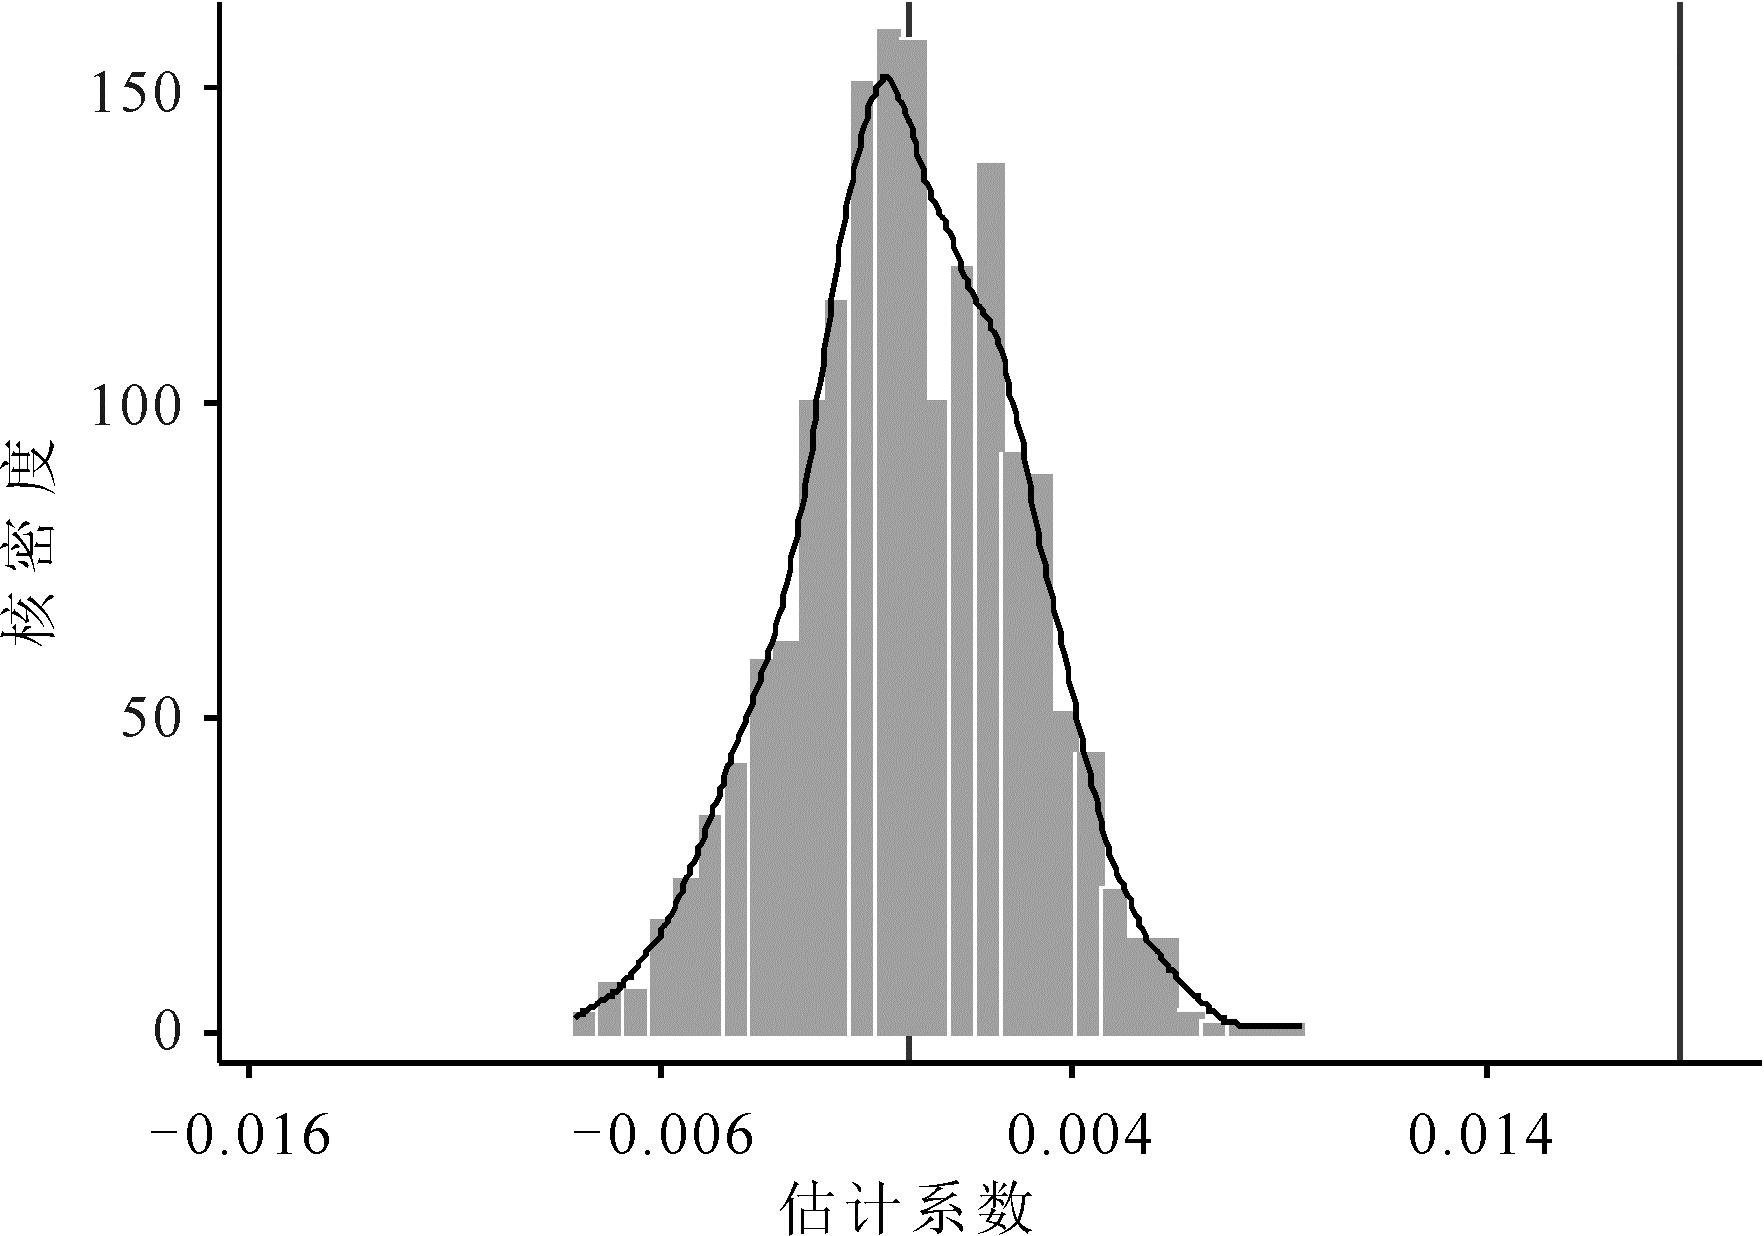
图2 安慰剂检验结果
Fig.2 Placebo test results
4.2.3 内生性检验
本文采用三种方式排除公共数据开放与产业链关联间可能存在的内生性问题。第一,采用倾向得分匹配法(K-PSM)处理政策的非随机性问题,通过加权平均的方式为处理组个体构建“虚拟对照”组,进行回归。第二,考虑到2020年新冠疫情突发公共卫生事件对城市产业发展带来的冲击,剔除2020年及以后的样本进行回归。第三,替换被解释变量,由于产业链现代化水平(Mod)的核心内涵与产业链关联高度契合,其涵盖产业链基础、产业链数字化、产业链创新、产业链韧性、产业链协同五个维度,本质是产业链关联从基础联结向高质量协同的进阶延伸,二者在测度逻辑上具有一致性与互补性,因此从上述维度构建综合指标体系测算该变量,替换产业链关联进行再检验。此外,考虑到产业链关联与地级市公共数据开放之间可能存在同期相关性问题,进一步将被解释变量分别滞后一期、两期进行回归。检验结果如表3所示,公共数据开放的估计系数均显著为正,且至少在5%的水平上显著。
表3 内生性检验结果
Table 3 Endogeneity test results
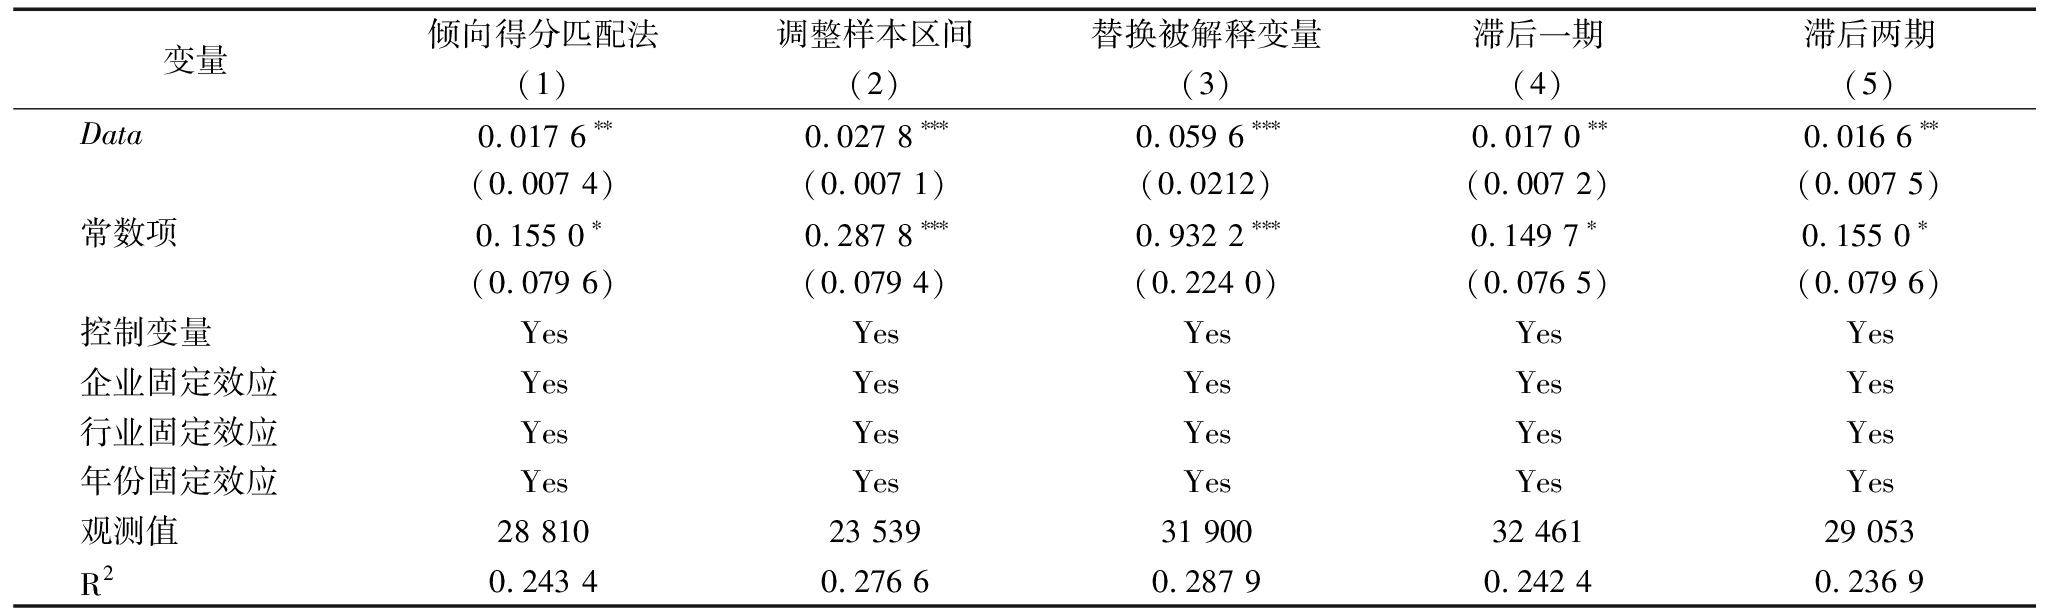
变量倾向得分匹配法调整样本区间替换被解释变量滞后一期滞后两期(1)(2)(3)(4)(5)Data0.017 6∗∗0.027 8∗∗∗0.059 6∗∗∗0.017 0∗∗0.016 6∗∗(0.007 4)(0.007 1)(0.0212)(0.007 2)(0.007 5)常数项0.155 0∗0.287 8∗∗∗0.932 2∗∗∗0.149 7∗0.155 0∗(0.079 6)(0.079 4)(0.224 0)(0.076 5)(0.079 6)控制变量YesYesYesYesYes企业固定效应YesYesYesYesYes行业固定效应YesYesYesYesYes年份固定效应YesYesYesYesYes观测值28 81023 53931 90032 46129 053R20.243 40.276 60.287 90.242 40.236 9
此外,本文采用工具变量法再次检验。参考现有研究构建两个工具变量:①借鉴魏达等[31]的做法,使用1984年城市邮局数与全国上一年互联网上网人数的交乘项(Post)作为公共数据开放平台的工具变量。②借鉴方锦程等[32]的做法,收集1985—2012年(公共数据开放平台上线前)的各城市历任市委书记籍贯特征,以其所在地距海岸线的平均距离与全国上一年互联网上网人数的交乘项(Coast)作为工具变量。估计结果如表4所示,Post和Coast的Cragg-Donald Wald F统计量分别为228.063和616.411,大于Stock-Yogo临界值16.38,证明不存在弱工具变量问题。列(1)(3)为第一阶段回归结果,工具变量(Post)与公共数据开放(Data)显著正相关,工具变量(Coast)与之呈显著负相关,符合预期;列(2)(4)为第二阶段回归结果,结果显示核心解释变量的估计系数在考虑工具变量后依旧显著为正,说明公共数据开放对产业链关联的积极作用在排除内生性影响后依旧稳健。
表4 工具变量法检验结果
Table 4 Results of the instrumental variables method test
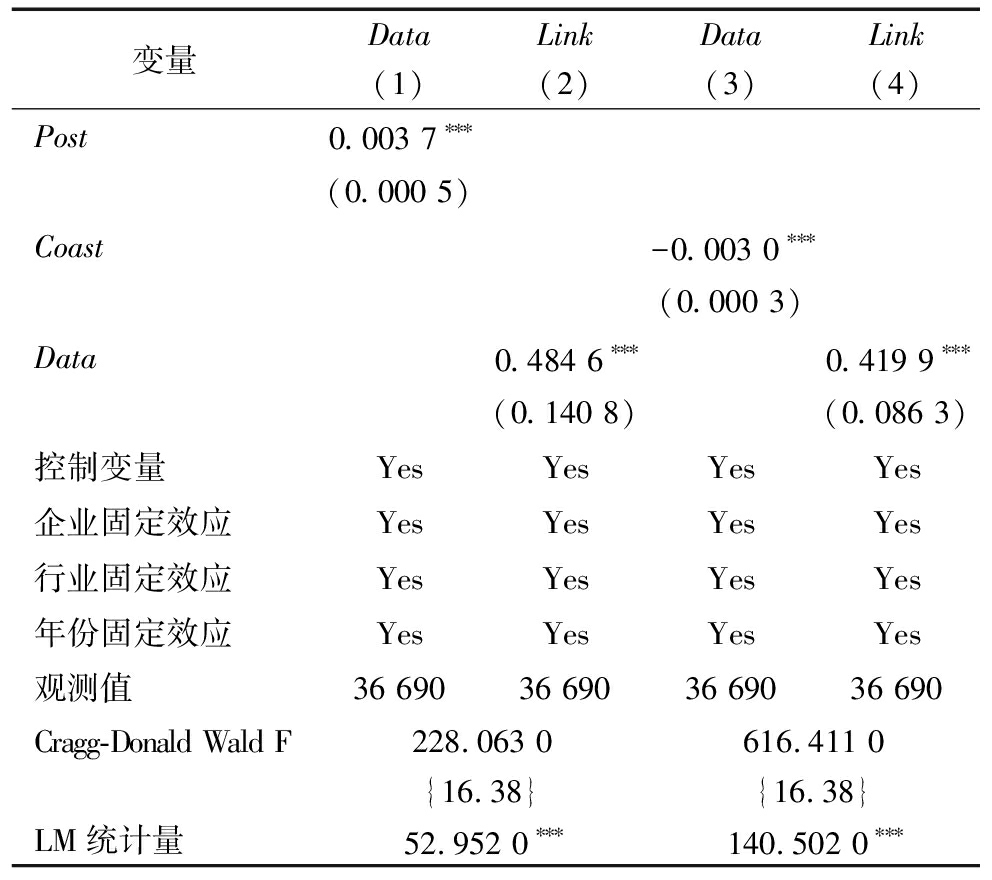
变量DataLinkDataLink(1)(2)(3)(4)Post0.003 7∗∗∗(0.000 5)Coast-0.003 0∗∗∗(0.000 3)Data0.484 6∗∗∗0.419 9∗∗∗(0.140 8)(0.086 3)控制变量YesYesYesYes企业固定效应YesYesYesYes行业固定效应YesYesYesYes年份固定效应YesYesYesYes观测值36 69036 69036 69036 690Cragg-Donald Wald F228.063 0 616.411 0{16.38}{16.38}LM统计量52.952 0∗∗∗140.502 0∗∗∗
4.2.4 其他稳健性检验
此外,本文从三个方面进行稳健性检验:第一,排除同时期政策干扰。为剔除样本期相关政策的潜在干扰,分别控制智慧城市试点、国家级大数据综合试验区、政务服务信息化、数据交易平台建设、信息惠民试点等五项试点政策。第二,异质性处理效应诊断及检验。为排除处理组因存在异质性效应而产生潜在的估计偏误,借鉴Sun等[33]的做法,计算组群—时期估计量、插补法估计量与堆叠估计量后进行检验。第三,更换双重机器学习模型。为避免传统模型“误设定”导致估计过程中的“维度诅咒”以及“正则误差”等问题,借鉴张涛和李均超[34]的做法,将样本分割比例设置成1∶4,同时添加控制变量二次项以保证估计精度,使用随机森林、Lasso回归、梯度提升、神经网络以及支持向量机等五种机器学习模型进行检验。以上稳健性估计结果如图3所示,公共数据开放的估计系数依旧显著为正。
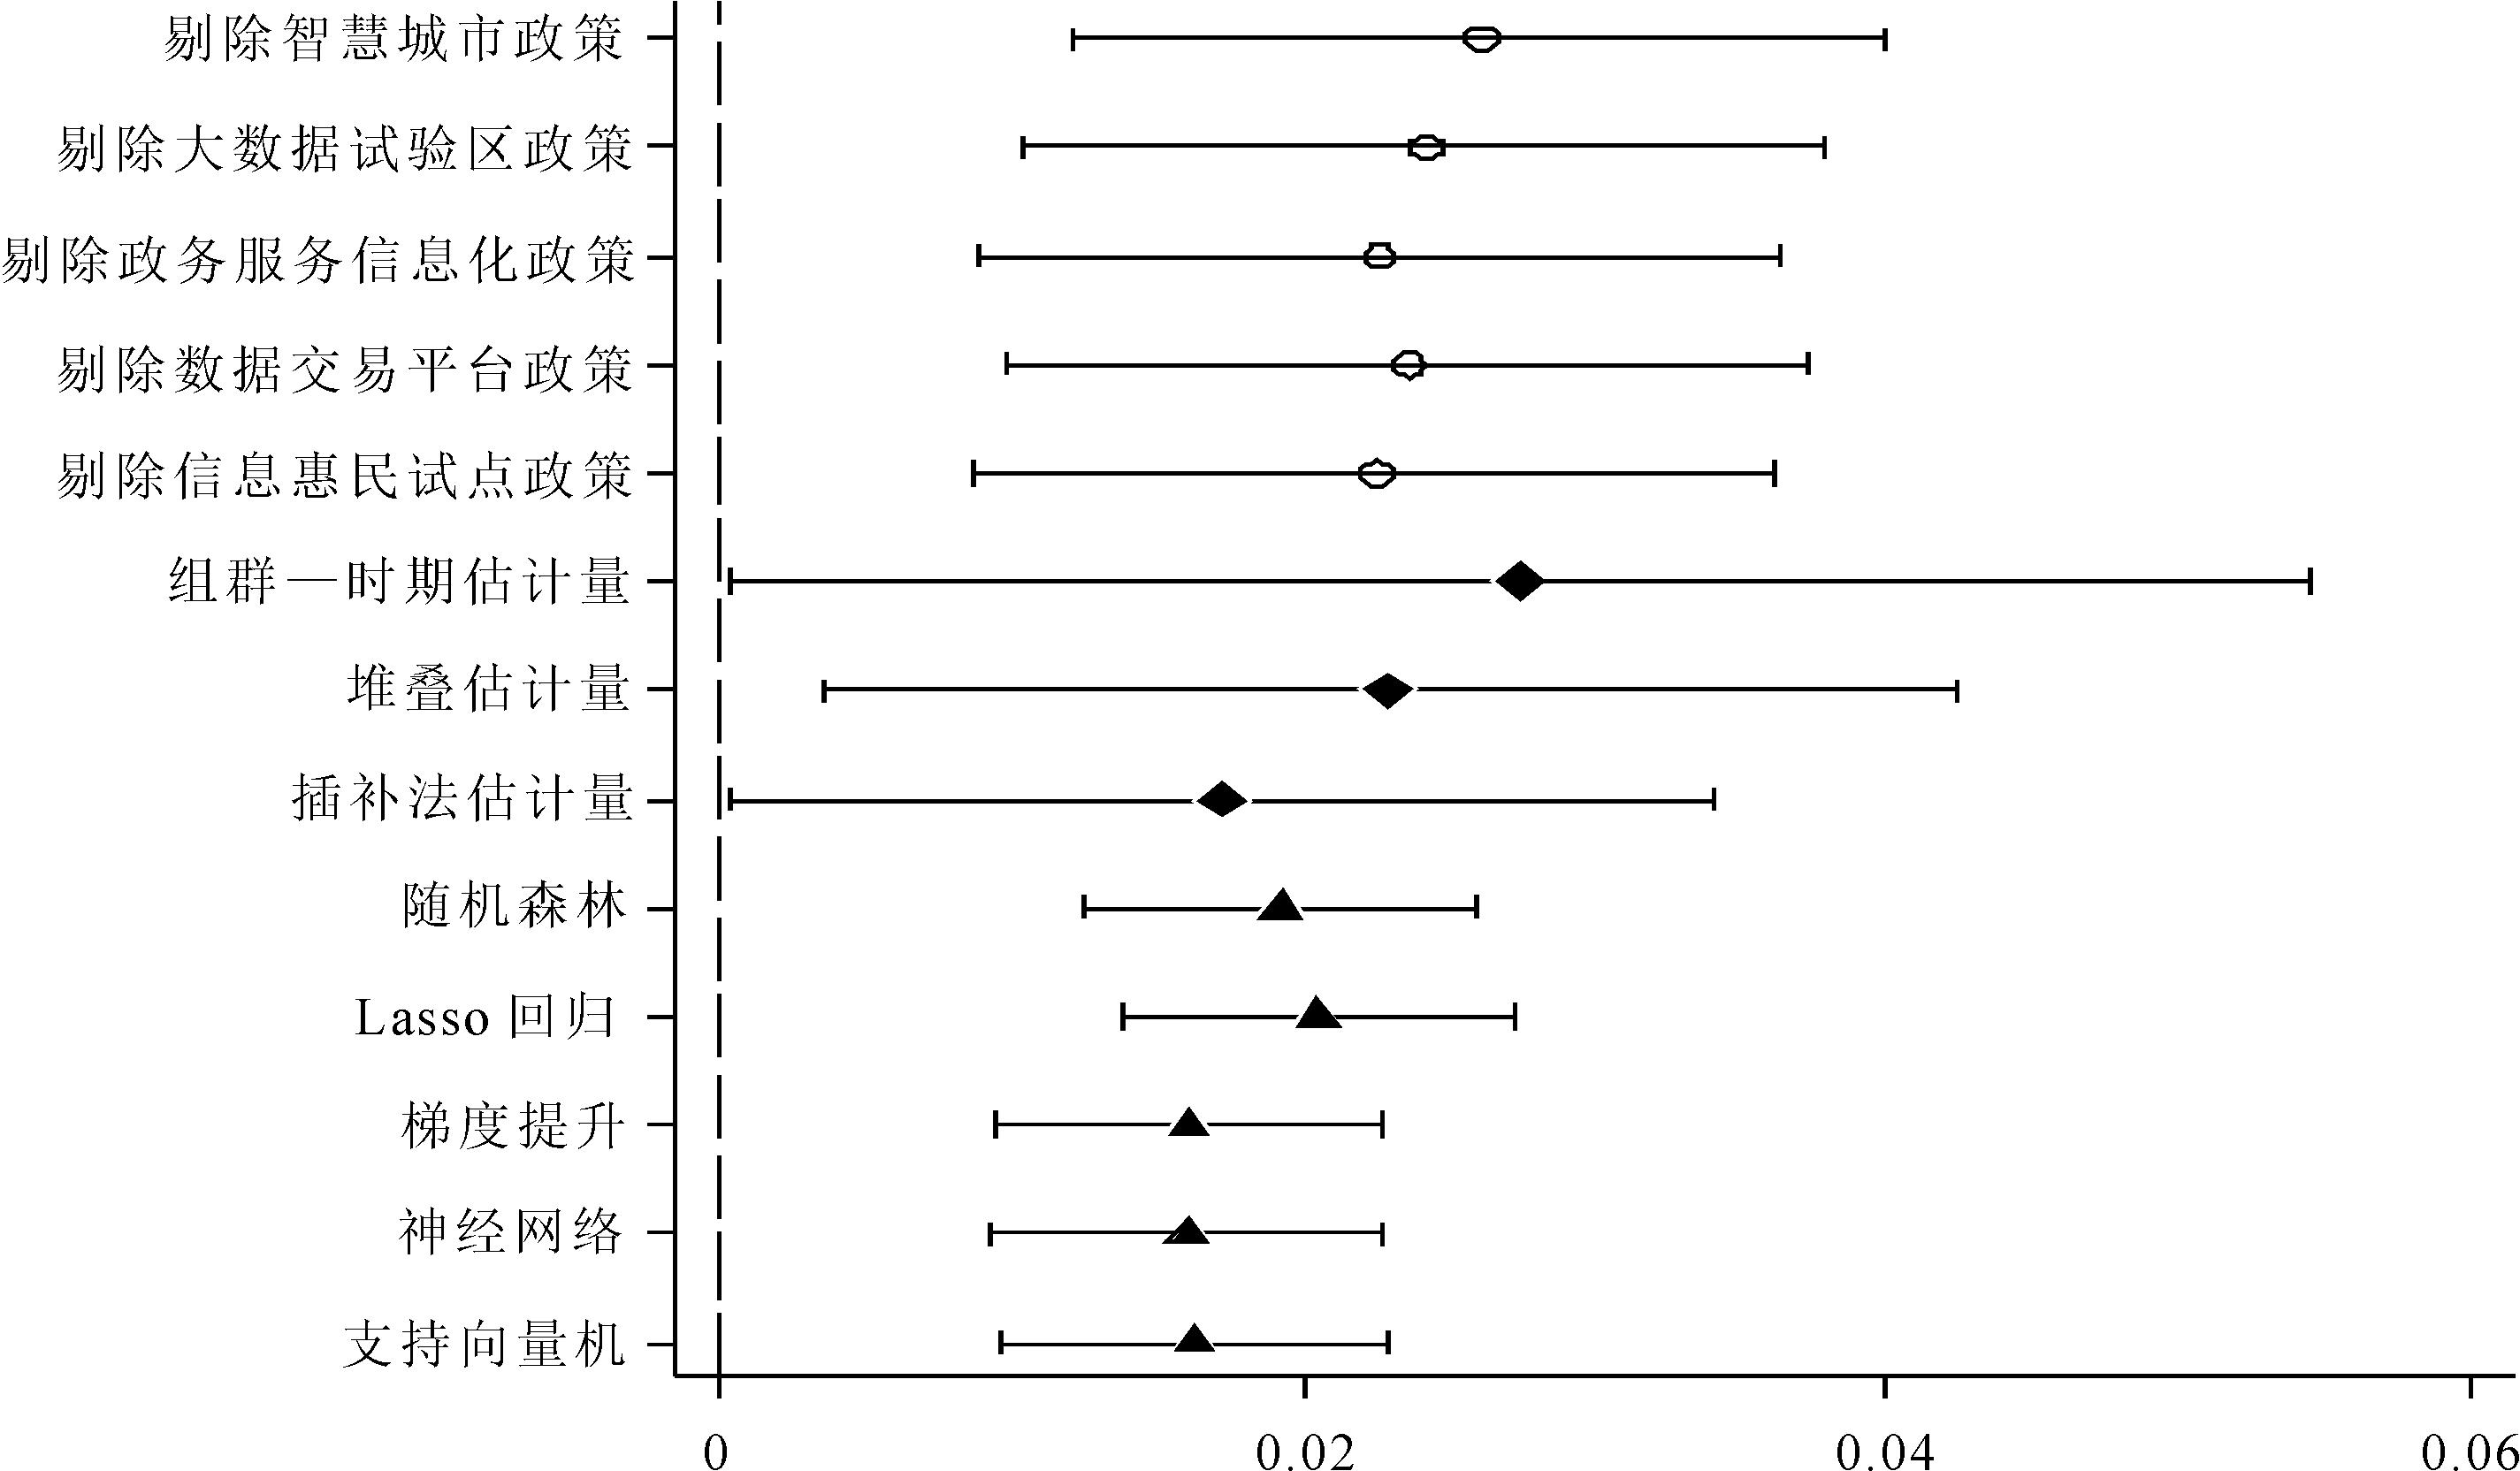
图3 其他稳健性检验结果
Fig.3 Other robustness test results
公共数据开放为企业人工智能应用提供了标准化、大规模的数据支撑,而人工智能应用通过高效的数据挖掘与分析,深度释放公共数据的潜在价值,放大公共数据开放对产业链关联的促进作用。基于此,本文进行调节效应检验,回归结果如表5所示,列(1)显示公共数据开放与人工智能应用的交互项系数显著为正,表明人工智能应用起到正向调节作用,假设H3得以验证。此外,本文将人工智能应用程度按照均值划分为低人工智能水平组、高人工智能水平组,列(2)(3)显示,在人工智能应用水平更高的企业中,公共数据开放的产业链关联效果显著为正,假设H3进一步得以验证。由此可见,在增强产业链关联时,政府不仅需深化公共数据开放,而且应注重推动企业应用人工智能技术,挖掘公共数据价值。
表5 人工智能应用的调节效应检验结果
Table 5 Moderating effect test results in artificial intelligence applications
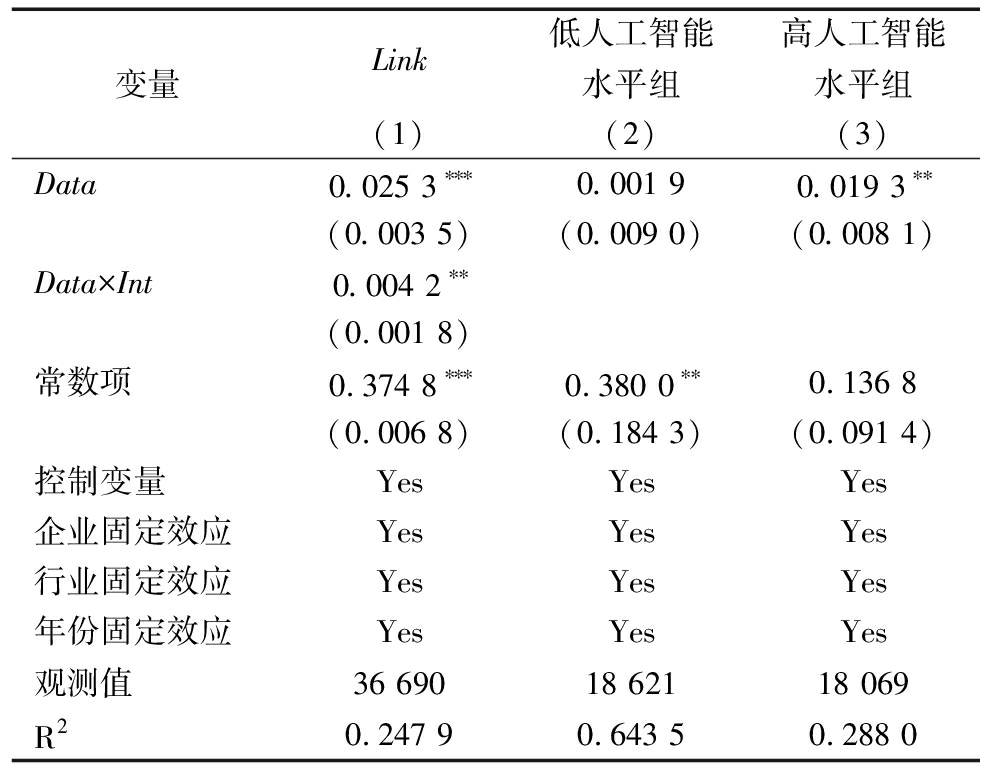
变量Link低人工智能水平组高人工智能水平组(1)(2)(3)Data0.025 3∗∗∗0.001 90.019 3∗∗(0.003 5)(0.009 0)(0.008 1)Data×Int0.004 2∗∗(0.001 8)常数项0.374 8∗∗∗0.380 0∗∗0.136 8(0.006 8)(0.184 3)(0.091 4)控制变量YesYesYes企业固定效应YesYesYes行业固定效应YesYesYes年份固定效应YesYesYes观测值36 69018 62118 069R20.247 90.643 50.288 0
为进一步探究公共数据开放影响产业链关联的内在机制,本文借鉴陈伟等[35]的做法,采用Bootstrap检验方法进行500次重复取样,并计算出95%置信区间,以验证其中介效应的显著性。该方法相较于传统的Sobel检验方法对统计量的要求更加灵活,不局限于正态分布,检验力也更高。检验结果如表6所示:①降成本效应中,中介变量交易成本(Tra)、上游话语权(Dup)和下游话语权(Ddown)的效应系数分别为0.000 7、0.000 4和0.001 4,至少在5%的水平上显著为正。②稳预期效应中,中介变量企业不确定性感知(Unpro)与不确定性词语增长(Urate)的效应系数分别为0.001 1和0.001 6,至少在5%的水平上显著为正。假设H2a、H2b均得以验证。③防风险效应中,中介变量企业的寻租程度(Exp)与寻租倾向(Exc)的效应系数分别为0.001 2和0.000 6,在5%的水平上显著为正。综上可知,降成本、稳预期和防风险的三种机制及中介变量的中介效应、直接效应和总效应的置信区间均不包含0,说明公共数据开放能够缩减制度性交易成本、降低不确定性感知、防范寻租风险,进而增强产业链关联,假设 H2a、H2b、H2c均得以验证。
表6 Bootstrap中介效应检验结果
Table 6 Bootstrap mediated effects test results
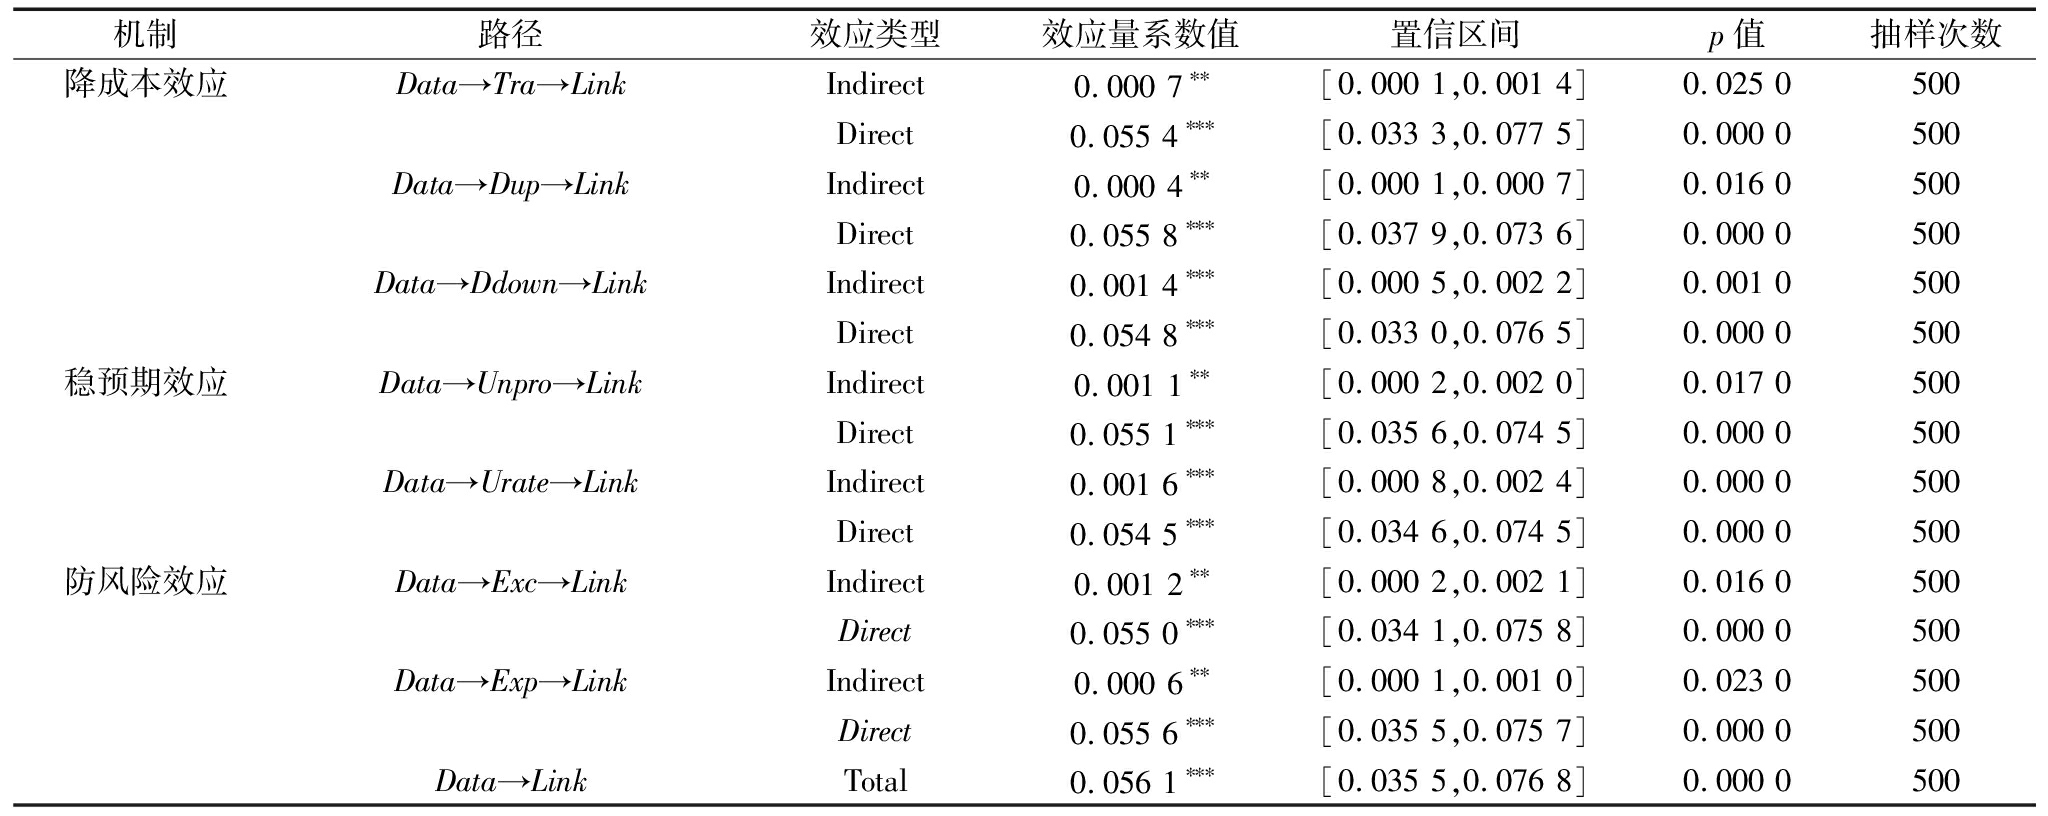
机制路径效应类型效应量系数值置信区间p值抽样次数降成本效应Data→Tra→LinkIndirect0.000 7∗∗[0.000 1,0.001 4]0.025 0500Direct0.055 4∗∗∗[0.033 3,0.077 5]0.000 0500Data→Dup→LinkIndirect0.000 4∗∗[0.000 1,0.000 7]0.016 0500Direct0.055 8∗∗∗[0.037 9,0.073 6]0.000 0500Data→Ddown→LinkIndirect0.001 4∗∗∗[0.000 5,0.002 2]0.001 0500Direct0.054 8∗∗∗[0.033 0,0.076 5]0.000 0500稳预期效应Data→Unpro→LinkIndirect0.001 1∗∗[0.000 2,0.002 0]0.017 0500Direct0.055 1∗∗∗[0.035 6,0.074 5]0.000 0500Data→Urate→LinkIndirect0.001 6∗∗∗[0.000 8,0.002 4]0.000 0500Direct0.054 5∗∗∗[0.034 6,0.074 5]0.000 0500防风险效应Data→Exc→LinkIndirect0.001 2∗∗[0.000 2,0.002 1]0.016 0500Direct0.055 0∗∗∗[0.034 1,0.075 8]0.000 0500Data→Exp→LinkIndirect0.000 6∗∗[0.000 1,0.001 0]0.023 0500Direct0.055 6∗∗∗[0.035 5,0.075 7]0.000 0500Data→LinkTotal0.056 1∗∗∗[0.035 5,0.076 8]0.000 0500
(1)产权性质。以往研究认为国有企业在市场环境和资源获取等方面占有天然优势[36],交易成本更低。近年来我国连续出台多项促进民营经济健康发展的政策措施,为民营企业破除平等使用生产要素、公平参与市场竞争的障碍。基于此,本文根据企业产权性质将样本分为国有企业和民营企业。实证结果如图4所示,民营企业较好地发挥了公共数据开放的产业链关联效应。这一结论证明了民营企业通常处于高度竞争的市场环境,公共数据开放成为其提升核心竞争力、抢占市场份额的重要手段,倒逼其快速响应数智技术迭代,挖掘数据价值。
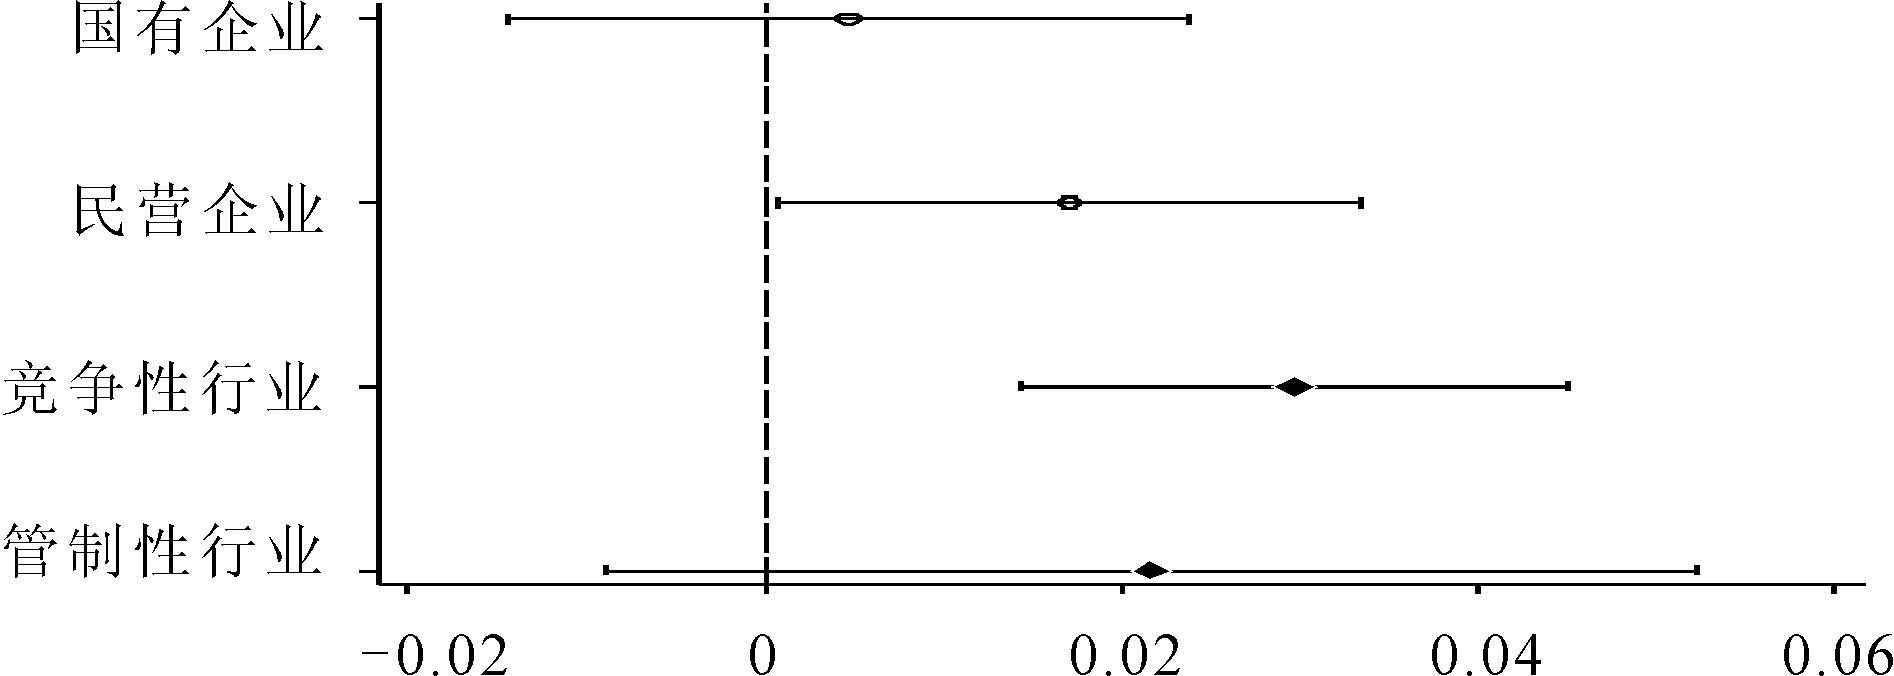
图4 降成本效应的异质性分析结果
Fig.4 Heterogeneity analysis results of the cost reduction effect
(2)行业管制。 考虑到不同管制程度行业的交易规则和交易对手的选择方式不同,致使交易成本存在较大差异。本文以证监会行业分类下的行业代码为划分依据,将行业区分为管制性行业和竞争性行业后分组回归。图4的实证结果显示,公共数据开放能显著提高竞争性行业的产业链关联水平,但对管制性行业几乎不产生影响,表明公共数据资源需进一步扩大开放规模,只有其顺畅流动并被充分利用,才能释放出更大的价值红利。
(3)行业性质。 随着数智时代的到来,高科技行业和非高科技行业在公共数据资源的处理利用与自身竞争力的建构方面具有明显差异,高科技行业更注重信息的时效性与前瞻性,非高科技行业更依靠自身的成本控制、人力资源等构建核心竞争力。因此,行业性质会致使公共数据开放的产业链关联效应发生变化。图5回归结果显示,公共数据开放的产业链关联效应仅在高科技行业呈现,说明这一效应的有效发挥有赖于行业的技术应用与数据挖掘水平。原因可能在于高科技行业凭借其原有技术基础,面对海量公共数据开放时,将原本难以预测的风险转化为可管理的数据模型,增强了投资信心,进一步扩展生产边界。
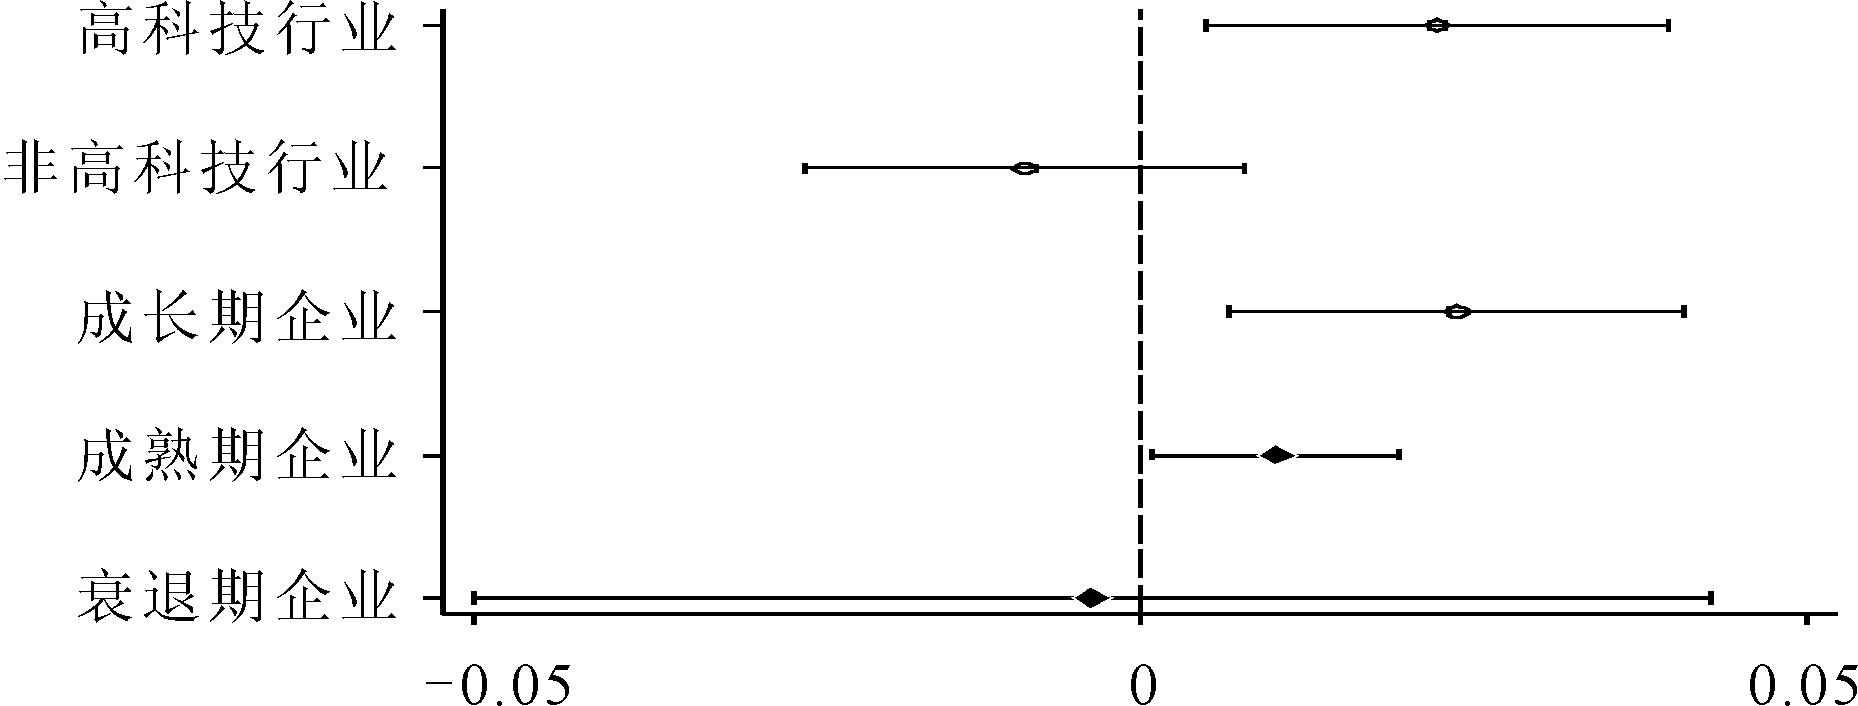
图5 稳预期效应的异质性分析结果
Fig.5 Heterogeneity analysis results of the expectation stabilization effect
(4)生命周期。 根据企业生命周期理论,企业的发展轨迹包括成长、成熟、衰退三个阶段,处于不同生命周期的企业,面对公共数据开放的主观感知和选择具有差异。借鉴薛龙和艾世杰[37]的方法确定企业生命周期的分类,实证结果如图5所示,公共数据开放对产业链关联的促进效应仅在成长期和成熟期企业中体现,在衰退期企业中则难以发挥。原因可能在于公共数据开放水平的提升能够促进成长期企业降低不确定性风险感知,助力其进一步开拓市场;对于成熟期企业亦能加速其技术变革,从而创造新的竞争优势和长期投资回报;而衰退期企业首要任务是“谋生存”而非“求发展”,其不确定性感知并未降低,仍然对公共数据开放下新的投资机遇持避险态度。
(5)融资约束。在面临较大融资约束时,企业囿于资金不足会有较大概率转向替代性渠道以弥补资金缺口,且融资约束高的企业往往缺乏市场议价能力,这使其更易通过寻租行为获取资源或政策倾斜,而寻租活动会破坏产业链上下游企业间的公平合作意愿,抑制产业链关联水平的提升。本文认为企业受融资约束程度的差异可能导致产业链关联效应的作用效果不同。利用KZ指数衡量企业融资约束程度,依据整体中位数将样本划分为融资约束高、融资约束低两组进行回归。图6的结果显示,公共数据开放的产业链关联抑制效应在高融资约束企业中存在。这一结论说明公共数据开放后,寻租风险提高,使企业倾向于从依赖关系资源转向依赖数据资源,公共数据开放抑制寻租行为的效果凸显。
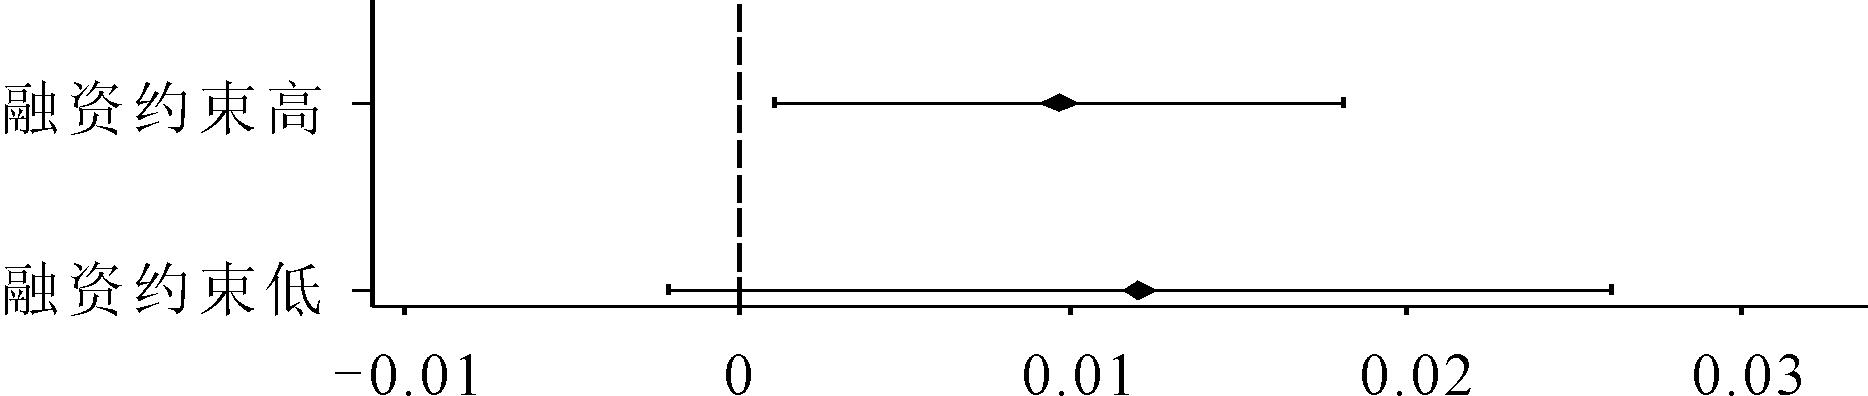
图6 防范风险效应的异质性分析结果
Fig.6 Heterogeneity analysis results of the risk prevention effect
5.2.1 对产业链韧性和安全水平的影响效应
产业链韧性和安全水平是建设现代化产业体系,巩固壮大实体经济根基的重要抓手。在此过程中,公共数据开放为企业提供了新技术组合的可能性。企业得以更快识别市场风险,打破原有技术依赖。基于此,本文尝试验证公共数据开放能否提升产业链韧性和安全水平,以期进一步丰富本文的政策价值。产业链韧性和安全水平是产业链面对风险和外部冲击时,能够维持自身稳定,并动态调整以迅速恢复原始状态的能力。参考肖兴志等[38]的研究,本文构建了一个涵盖预测能力、抵抗能力、恢复能力等在内的综合指标体系,以测度产业链韧性和安全水平(Res)。表7列(1)显示,公共数据开放能显著提升产业链韧性和安全水平,同时也说明公共数据开放不仅关乎单个行业企业,更关乎国家产业链供应链的安全稳定和长期发展。
表7 进一步讨论检验结果
Table 7 Further discussion of the test results
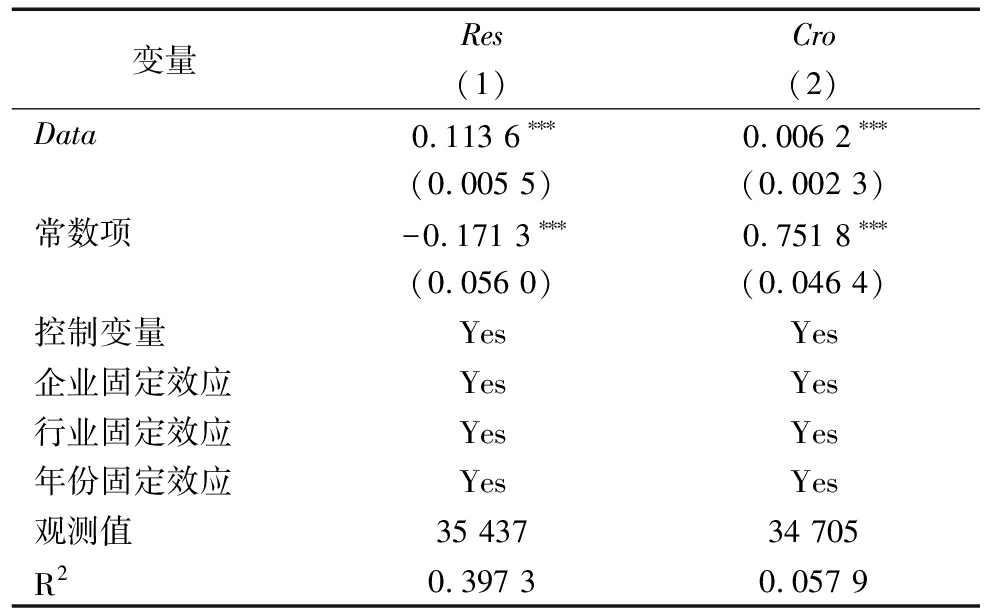
变量ResCro(1)(2)Data0.113 6∗∗∗0.006 2∗∗∗(0.005 5)(0.002 3)常数项-0.171 3∗∗∗0.751 8∗∗∗(0.056 0)(0.046 4)控制变量YesYes企业固定效应YesYes行业固定效应YesYes年份固定效应YesYes观测值35 43734 705R20.397 30.057 9
5.2.2 对产业跨区域关联的影响效应
党的二十届四中全会提出:“优化区域经济布局,促进区域协调发展”。产业链关联包括跨企业和跨行业关联两个层面。本文试图回答公共数据开放是否能够增强产业跨区域关联,进而推动区域经济协调发展。爬取上市公司(焦点企业)的前五大客户企业与前五大供应商企业信息,并手工搜索客户(供应商)企业所在地,将与焦点企业处于不同省份的客户(供应商)企业数量与样本总数的比值作为产业跨区域关联(Cro)的代理变量。回归结果如表7列(2)所示,公共数据开放显著促进了产业跨区域关联,表明公共数据作为新型生产要素的价值释放,能够驱动区域间产业基于比较优势和互利共赢开展深度分工协作,形成优势互补、高质量发展的区域产业布局,促进更高层次的区域协调发展。
本文以产业链关联为切入点,立足于地级市公共数据平台陆续上线的研究场景,构建多期双重差分模型对沪深两市A股上市公司2008—2023年面板数据进行实证检验。研究发现:第一,公共数据开放能够有效促进产业链关联,经过一系列稳健性检验,这一结论依然成立。第二,人工智能应用是释放公共数据价值、加速产业链关联的重要调节变量,人工智能水平越高的企业,其在产业链关联中的表现越好。第三,机制检验表明,公共数据开放能够通过降成本、稳预期、防风险三重机制对产业链关联产生影响。第四,异质性分析发现,公共数据开放在民营企业、竞争性行业企业、高科技行业企业、成长期和成熟期企业以及融资约束高的企业中具有更强的产业链关联促进作用。第五,公共数据开放不仅能提升产业链韧性和安全水平,也能激发产业跨区域关联,推进区域经济协调发展。
(1)挖掘公共数据开放价值,构建分级分类开放体系。一方面拓宽开放范围,重点纳入产业链急需的行业产能监测、跨区域物流调度等公共资源交易数据,建立企业核心经营数据保护机制与“可开放、可授权、受限制”三级目录动态调整机制,定期公示更新;另一方面搭建分级分类供需对接体系,降低民营企业、初创企业信息获取与应用门槛,精准对接高融资约束企业的信用评价、合规备案、融资对接等需求,缓解合作壁垒与融资难题。
(2)拓展数字应用场景,发挥公共数据的降成本、稳预期、防风险作用。一方面依托人工智能技术深化开放程度,通过生成式人工智能实现智能搜索、可视化呈现等功能,利用公共数据库训练专业算法模型,推动公共数据赋能场景化、智能化、精准化;另一方面通过媒体宣传、公益培训普及应用知识、开放意见反馈端口等,建立自下而上的参与创新机制,保障相关政策落地见效。
(3)深化公共数据开放在产业链韧性与跨区域关联中的融合应用,加快现代化产业体系构建。一方面健全跨区域共享与协同开放机制,制定统一标准的数据共享清单,破除制度壁垒,共建规范公共数据资源库;另一方面推动公共数据与硬科技产业深度耦合、与前沿技术融合创新,降低行业知识准入门槛,强化资金保障与人才培育,搭建产业链安全监测平台,建立公共数据预警与应急政策响应联动机制,促进多方协同治理。
本研究仍存在以下不足:首先,聚焦地级市公共数据开放平台的影响,尚未充分考量不同地区开放程度、不同数据类型对企业的差异化影响,可能低估公共数据开放的实际效应。受限于公共数据体量和统计口径,目前难以全面精准测度其开放程度,未来可依托日趋完善的信息披露制度,借助大语言模型等文本识别技术优化测度方法。其次,机制分析仅对公共数据开放的影响过程开展一般性探讨,缺乏对不同关联水平地区差异性与共性的挖掘,后续可结合多案例比较、扎根理论等方法,细化作用机理以丰富相关研究。最后,囿于样本数据的可得性,研究结论仅适用于上市公司,未来可通过单案例分析与深度访谈进一步深化相关研究。
[1] 刘备,邱兆轩.我国制造业产业链现代化: 理论逻辑、模式选择与实现路径[J].经济学家,2025,37(4): 68-78.
[2] 周文,韩文龙.数字财富的创造、分配与共同富裕[J].中国社会科学,2023,44(10): 68-85.
[3] 彭远怀.政府数据开放的价值创造作用: 企业全要素生产率视角[J].数量经济技术经济研究,2023,40(9): 50-70.
[4] 孙大明,胡苏敏,朱天一,等.工业互联网平台如何驱动新质生产力发展——基于数据要素视角[J].科技进步与对策,2025,42(3): 38-49.
[5] 李丹,李旭浦.数据要素如何赋能企业新质生产力——基于效应分解视角[J].科技进步与对策,2025,42(8): 1-12.
[6] 高静,陈峰,李丹,等.公共数据开放促进县域经济高质量发展的效应与机理[J].中国农村经济,2025,41(5): 145-165.
[7] 潘俊,孙昊晨,王禹,等.公共数据开放对企业投资的微观治理效应研究——基于地方政府构建数据开放平台的准自然实验[J].会计研究,2025,46(3): 130-146.
[8] 白雪洁,程钰娇.中间品企业跨越中等技术陷阱: 基于应用基础研究传导的视角[J].中国工业经济,2025,42(8): 103-120.
[9] 李杰,杨海生,谢婉晴,等.数字经济核心部门技术进步、新增产业关联与经济效应——基于生产网络的分析框架[J].经济研究,2025,60(5): 55-71.
[10] 徐洪,黄璐,刘明熹,等.人才链创新链产业链深度融合——理论逻辑、融合现状与提升路径[J].科学学研究,2025,43(8): 1666-1675.
[11] 张同斌,刘文龙.留抵退税改革、融资约束与企业产业链关联[J].管理世界,2024,40(3): 94-115.
[12] 康健,曹执令,谢诗蕾.数据要素赋能专精特新企业新质生产力涌现机制及其适配组态研究[J].科技进步与对策,2025,42(8): 13-23.
[13] NAGARAJ A. The private impact of public data: landsat satellite maps increased gold discoveries and encouraged entry[J]. Management Science, 2022, 68(1): 564-582.
[14] BERAJA M, YANG D Y, YUCHTMAN N. Data-intensive innovation and the state: evidence from AI firms in China[J]. Review of Economic Studies, 2022, 90(4): 1701-1723.
[15] 蒋余浩,贾开.公共数据牵引与数据要素共享式开放: 改变现状权的理论视角[J].电子政务,2024,21(5): 43-52.
[16] 刘敏,朱亚鹏,肖霞,等.公共数据开放如何提升城市韧性——基于城市政府治理和营商环境的视角[J].公共管理与政策评论,2025,14(5): 18-39.
[17] 刘丽娜.公共数据资源利用的政府责任与义务的法律边界[J].行政论坛,2025,32(4): 109-116.
[18] 蒋国银,庞正恒.公共数据开放何以促进平台经济规范健康持续发展——基于公共数据开放的准自然实验[J].统计研究,2025,42(6): 51-65.
[19] 张云昊,王磊.公共数据开放伦理: 概念界定、内在困境与治理路径[J].科技进步与对策,2025,42(5): 12-20.
[20] 卜伟,张应允.公共数据开放对新质生产力的赋能效应——基于社会再生产视角[J].科技进步与对策,2025,42(20): 129-141.
[21] 张虎,高子桓,韩爱华.企业数字化转型赋能产业链关联: 理论与经验证据[J].数量经济技术经济研究,2023, 40(5): 46-67.
[22] ZHENG H, FANG Q, WANG C. Updating China′s input-output tables series using MTT method and its comparison[J]. Economic Modelling, 2018,74(1): 186-193.
[23] 范子英,彭飞.“营改增”的减税效应和分工效应: 基于产业互联的视角[J].经济研究,2017,52(2): 82-95.
[24] 何雨可,牛耕,逯建,等.数字治理与城市创业活力——来自“信息惠民国家试点”政策的证据[J].数量经济技术经济研究,2024,41(1): 47-66.
[25] 倪骁然,张宸瑞.数字化转型与企业资本配置效率[J].统计研究,2025,42(2): 43-57.
[26] 聂辉华,阮睿,沈吉.企业不确定性感知、投资决策和金融资产配置[J].世界经济,2020,43(6): 77-98.
[27] 陈骏,徐捍军,林婧华.企业寻租如何影响审计意见购买[J].会计研究,2021,38(7):180-192.
[28] 杨洁,史今,王兴光.政府推动的企业数字化转型对成本粘性的影响研究[J].管理学报,2024,21(12):1860-1869.
[29] 王娇,孙慧,廖振良.人工智能技术促进“双碳”目标实现的影响机制研究[J].科技进步与对策,2025,42(15): 11-23.
[30] 张鹏杨,刘蕙嘉,张硕,等.企业数字化转型与出口供应链不确定性[J].数量经济技术经济研究,2023,40(9): 178-199.
[31] 魏达,李豫新,孙晓涵.政府数字治理对现代化产业体系的赋能效应与协同机制研究[J].现代财经(天津财经大学学报),2026,46(2):3-22.
[32] 方锦程,刘颖,高昊宇,等.公共数据开放能否促进区域协调发展?——来自政府数据平台上线的准自然实验[J].管理世界,2023,39(9): 124-142.
[33] SUN L Y, ABRAHAM S. Estimating dynamic treatment effects in event studies with heterogeneous treatment effects[J]. Journal of Econometrics, 2021, 225(2): 175-199.
[34] 张涛,李均超.网络基础设施、包容性绿色增长与地区差距——基于双重机器学习的因果推断[J].数量经济技术经济研究,2023,40(4): 113-135.
[35] 陈伟,邓堯,杨柏,等.人工智能能否赋能区域技术创新——创新环境的中介效应[J].科技进步与对策,2024,41(10): 57-66.
[36] 王晓东,许雅琳,王诗桪.政府治理视角下的国有流通企业: 功能定位及其逻辑[J].中国行政管理,2022,38(5): 66-72.
[37] 薛龙,艾世杰.耐心资本对企业绿色技术创新的影响——ESG表现的中介效应[J].科技进步与对策,2025,42(17): 79-90.
[38] 肖兴志,王振宇,李少林.产业链韧性测度方法研究进展[J].经济学动态,2024,66(4): 144-160.